
Веса моделей DeepSeek и Kimi указали на чипы Blackwell
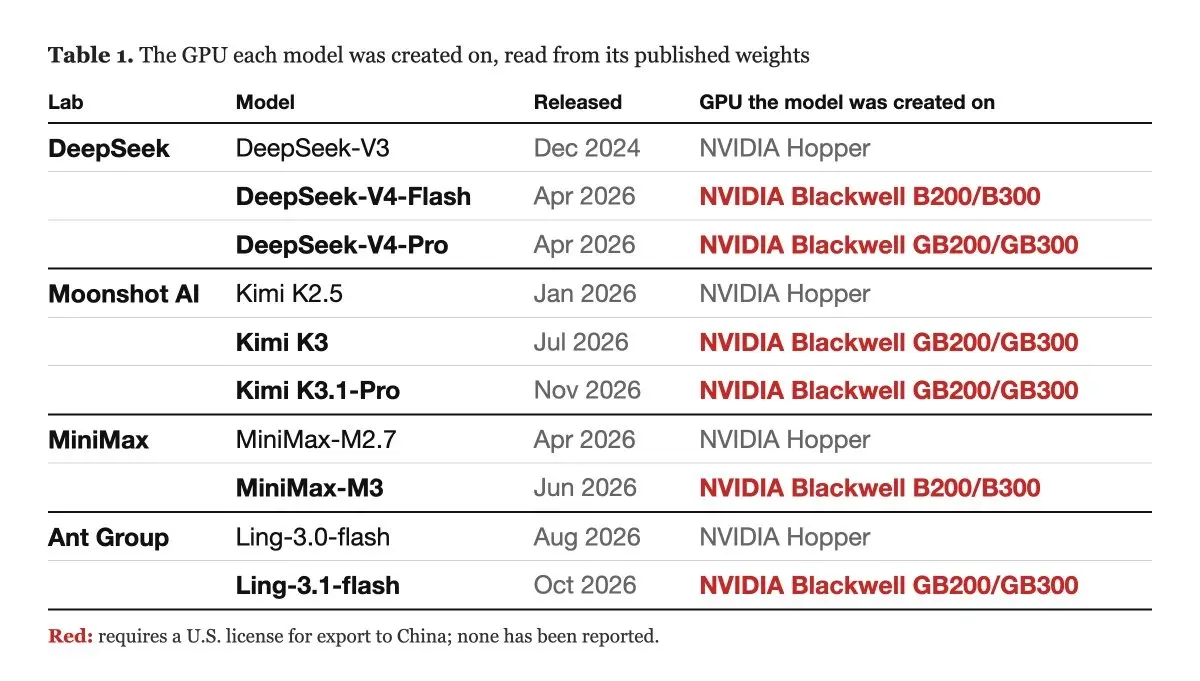
Бывший исследователь OpenAI Депью (DePue) нашёл в открытых весах шести моделей DeepSeek, Moonshot AI, MiniMax и Ant Group, вышедших с апреля 2026 года, числовой отпечаток чипов NVIDIA Blackwell, на экспорт которых в Китай нужна лицензия США. Измерено в его отчёте Unemployment Labs (последняя редакция от 12 ноября) ровно одно: на каком железе создавались стартовые веса. Обучение на Blackwell, размеры кластеров и их цена выводятся с оговорками, а где стояли чипы, как к ним получили доступ и нарушен ли экспортный контроль, метод, по признанию автора, не устанавливает.
Отпечаток B200 или B300, у которых по 148 потоковых мультипроцессоров (SM, вычислительных блоков GPU), нашёлся у DeepSeek-V4-Flash и MiniMax-M3. DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro и Ling-3.1-flash совпали с GB200 или GB300, где таких блоков 152: эти чипы стоят во флагманских стоечных системах NVIDIA с жидкостным охлаждением. Kimi K3.1-Pro стартует с того же зерна, что и K3, и может оказаться чекпоинтом K3 с дополнительным дообучением, а в оценках масштаба фигурируют пять запусков.
Предыдущие модели тех же лабораторий читаются как Hopper: DeepSeek-V3 (декабрь 2024 года), Kimi K2 и K2.5 (июль 2025 и январь 2026 года), MiniMax-M2.7 (апрель), Ling-3.0-flash (август). H800 от H100 SXM и H200 метод не отличает, у них один отпечаток, и H800 в таблице отчёта взяты из заявлений самих лабораторий. Между двумя поколениями застряла Kimi K2.7-Code: её выложили за шесть недель до K3, она собрана на весах времён Hopper, но небольшая её часть совпадает с B200 или B300.
Перешли не все. Новейшие модели Alibaba (Qwen), Zhipu (GLM), Tencent, Xiaomi и StepFun, которые удалось прочитать, указывают на Hopper. Meituan говорит, что обучила LongCat-2.0 целиком на «суперподах из ИИ-ASIC», и отпечатка NVIDIA в её опубликованных весах не нашлось.
Как чип оставляет след в весах
До обучения весам нужны начальные значения. В PyTorch их выдаёт генератор псевдослучайных чисел Philox: из одного числа-зерна он каждый раз строит одну и ту же последовательность. Чтобы быстро заполнить миллиарды весов, работа через библиотеку NVIDIA cuRAND делится между параллельными потоками, и при большой инициализации их по 2 048 на каждый SM. Каждый поток генерирует свои числа из зерна, а общее число потоков решает, в какие позиции они лягут. У Hopper (H100, H800, H200) 132 SM, у B200 и B300 - 148, у GB200 и GB300 - 152, поэтому одно и то же зерно на разных чипах даёт разную раскладку. В упрощённом примере из отчёта, где 48 потоков сменяются на 40, на своих местах остаётся всего 6% значений.
Обучение перезаписывает большую часть стартовых значений, но в каждой большой модели остаются строки матриц, которые практически не менялись. Собрав достаточно таких строк, можно искать, какая пара из зерна и раскладки их породила. Автор перебрал около 6 триллионов таких комбинаций. Лучшее случайное совпадение при таком переборе дотянуло бы примерно до 8 сигм (мера того, насколько результат выбивается из обычного случайного разброса), а у шести моделей сильнейшие совпадения дают от 49 до 1 385 сигм; самый слабый отдельный тест доходит до 20.
Для двух моделей совпадение повторили на железе. По словам Депью, B300 с немодифицированным PyTorch и восстановленным зерном воспроизвёл нетронутые стартовые веса DeepSeek-V4-Flash бит в бит, а арендованный GB200 повторил веса Kimi K3 с корреляцией 0,999995. H100 не воспроизвёл ни одного значения V4-Flash, а сдвиг зерна на единицу ломал совпадение. Зерно DeepSeek автор привёл тут же: 953049583.
На 24 моделях, для которых разработчики сами назвали железо, метод каждый раз сошёлся с их заявлениями. Nemotron-3 Ultra от NVIDIA, в техотчёте которой GB200 указан для одного из этапов обучения, читается как 152 SM, так же как Kimi K3. Единственная найденная альтернатива - ускорители AMD MI300X, экспорт которых в Китай тоже ограничен: если настроить их на 148 или 152 блока, они могут повторить раскладку Blackwell. Для DeepSeek-V4-Flash автор этот вариант исключил, MI300X не воспроизвёл ни одной её строки, а для остальных пяти моделей считает его очень маловероятным. Депью пишет, что «очень уверен» в результате и что его независимо проверили старшие исследователи OpenAI и Anthropic.
Тысячи GPU и сотни миллионов долларов
Оценки масштаба стоят на допущениях, которые по весам не проверить, и цифры из поста самого автора уже устарели: там 2 000-3 000 Blackwell на каждый из двух крупнейших запусков и 150-200 миллионов долларов за кластер. В обновлённой редакции отчёта их заменили, потому что первая версия исходила из эффективности GPU как в бенчмарках NVIDIA, а раскрытые запуски на Blackwell шли менее эффективно.
Новые лучшие оценки: около 4 500 GPU для Kimi K3 (разброс 1 000-9 500) и около 3 000 для DeepSeek-V4-Pro (750-6 500), примерно по 70 дней обучения, если модель обучали на том же железе, что создало её веса. В пересчёте на H100, которыми обычно меряют кластеры, это около 11 500 и 7 500. На все пять запусков выходит около 12 000 Blackwell с разбросом 7 000-22 000. Цену автор выводит из сообщения Wall Street Journal о том, что около 36 000 Blackwell, которые ставят в Малайзии для ByteDance, обойдутся больше чем в 2,5 миллиарда долларов: это примерно 70 000 долларов за GPU, 200-300 миллионов за крупнейший кластер и больше полумиллиарда за все пять. В расчёт входят только финальные прогоны, без экспериментов, ранних запусков и обслуживания моделей, а общие траты лабораторий на такие GPU, по оценке автора, вероятно, исчисляются миллиардами долларов.
Сильнее всего итог зависит от длительности запуска, которую автор выводит из графиков релизов: вдвое более короткий прогон вдвое увеличивает число GPU. Загрузку чипов он принимает около 20% от пиковой (25% для DeepSeek, которая для прошлой модели сообщала о 39%), а число токенов для всех, кроме DeepSeek, оценивает по весам методом, который ещё не опубликовал. Разброс видно по двум раскрытым запускам: Mistral обучила Mistral Large 4, у которой столько же активных параметров, сколько у DeepSeek-V4-Pro, на 3 800 GPU Grace Blackwell, а Microsoft обучила MAI-Base-2 похожего размера, но на большем объёме данных, на 16 000 GPU за 38 дней. В темпе Microsoft двум крупнейшим запускам понадобилось бы 8 000-9 000 Blackwell.
Записи Nvidia и законопроекты
Американские чиновники и пресса и раньше утверждали, что DeepSeek и Moonshot AI работают на Blackwell, но технических доказательств не публиковали. Отчёт ложится в уже идущий спор о доступе Китая к чипам: в ноябре OpenAI, как сообщает Bloomberg, подтвердила законодателям, что поддержит двухпартийный пакет законопроектов, закрывающий Китаю доступ к ИИ-чипам.
11 ноября сенаторы Элизабет Уоррен и Крис Кунс призвали администрацию Трампа сохранить экспортные записи Nvidia. Днём позже The Information сообщила, что компании, связанные с Элис Хуан (Alice Huang), вложились в DeepSeek и пообещали ей чипы Nvidia.
Дальше
Claude Code Projects: координатор сам сообщает о статусе
В Claude Code Projects действует лимит в 200 новых потоков в день на аккаунт, но все эти параллельные сессии расходуют тот же лимит Claude Code. И несколько сессий с высоким усилием выбирают план быстрее одной. Параллельные сессии Claude Code у вас идут пачкой или строго по одной?
Читайте также
- Bloomberg: OpenAI поддержит законы об экспорте чипов
- The Information: DeepSeek и Moonshot учились на GPT-6 Astra
- DeepSeek выложила движок своего API, Huawei наравне с Nvidia
- Muse Spark Open от Meta умещается в два Mac Studio
- Surface Laptop Ultra тянет локальные модели, пока в розетке
- Поиск на Qwen исчез с сайта Федерального реестра США
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.