
Минорный апдейт DeepSeek обогнал Opus 5 на DeepSWE
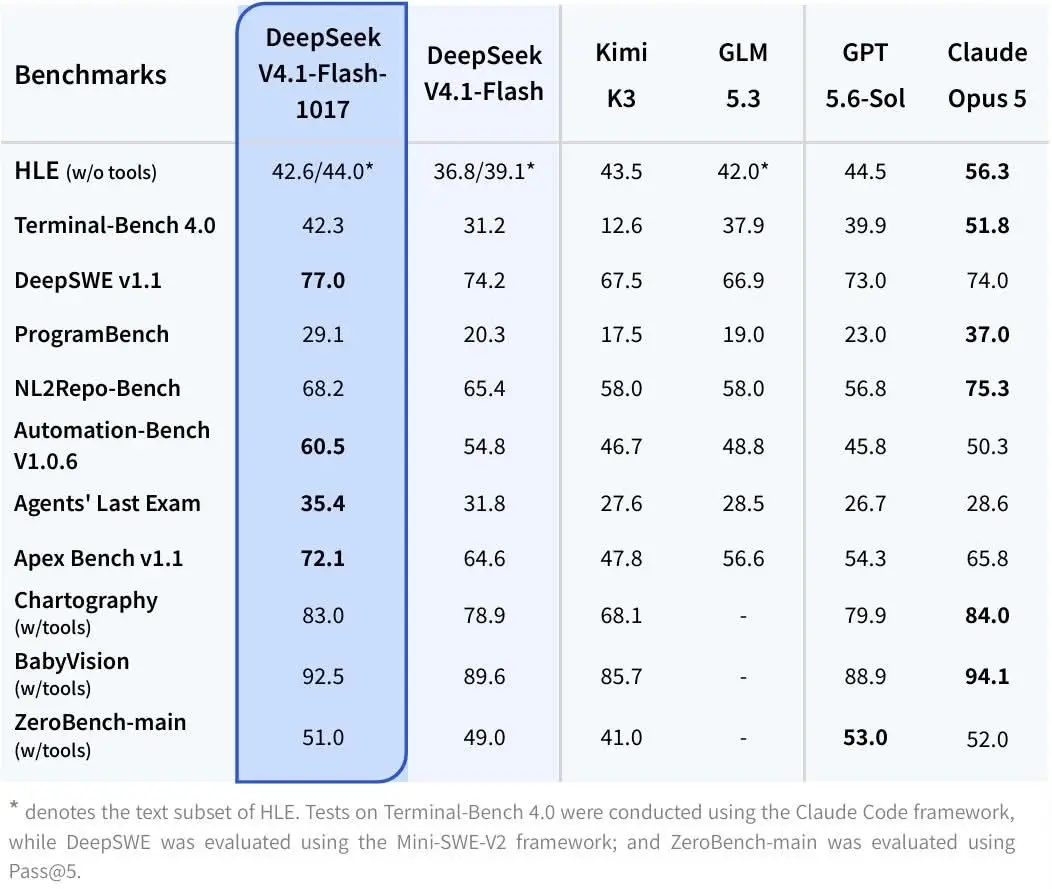
Обновление, которое DeepSeek сама называет минорным, добавило V4.1-Flash 11,1 пункта на Terminal-Bench 4.0: 42,3 против 31,2 у сентябрьской версии. Этот результат и все остальные цифры ниже взяты из собственной таблицы компании в карточке DeepSeek-V4.1-Flash-1017 на Hugging Face.
Первой о релизе 17 октября написала Testing Catalog в Threads. Она выделила 77% на DeepSWE 1.1 и сообщила, что модель уже доступна в DeepSeek Chat, через API и на Hugging Face. Ещё Testing Catalog называет модель очень дешёвой. В карточке цен нет. По данным Mungomash, DeepSeek снизила цены API 10 сентября, вместе с выходом V4.1-Flash. До этого, 16 августа, компания перешла на тарифы с пиковыми и непиковыми часами, и тогда подорожали все ставки.
Прибавка к сентябрьской версии
V4.1-Flash вышла 10 сентября. Это MoE-модель на 552 миллиарда параметров в новой архитектуре Causal Encoder-Decoder: на входе у неё работают 8 миллиардов параметров, на выходе 16 миллиардов, а KV-кэш вчетверо меньше, чем у предыдущего поколения. Контекстное окно 1M токенов, веса открыты под MIT в день релиза. Размеры для 1017 в карточке не повторяются: релиз описан как минорное обновление той же V4.1-Flash, а в цитате указана статья «DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression».
В таблице 11 бенчмарков, и на всех 1017 обходит сентябрьскую сборку. Прибавка от 2,0 до 11,1 пункта. Сильнее всего выросли агентные задачи и большой код:
- Terminal-Bench 4.0: 31,2 → 42,3
- ProgramBench: 20,3 → 29,1
- Apex Bench v1.1: 64,6 → 72,1
- HLE без инструментов: 36,8 → 42,6 (на текстовом подмножестве 39,1 → 44,0)
- Automation-Bench v1.0.6: 54,8 → 60,5
DeepSWE v1.1, на котором держится заголовок, вырос всего с 74,2 до 77,0. По прибавке он в нижней четвёрке вместе с ZeroBench-main (49,0 → 51,0, на нём рост минимальный), NL2Repo-Bench (65,4 → 68,2) и BabyVision (89,6 → 92,5). Agents’ Last Exam прибавил 3,6 пункта, до 35,4, Chartography 4,1 пункта, до 83,0.
Ещё DeepSeek заявляет, что модель быстрее выполняет задачи и пишет более короткие ответы, поэтому обходится дешевле, и что она сдвигает «Парето-фронт» соотношения качества и цены в нескольких агентных обвязках. Ни времени выполнения, ни числа токенов в карточке нет. Обвязки в таблице названы только для двух тестов: Claude Code для Terminal-Bench 4.0 и Mini-SWE-V2 для DeepSWE v1.1. Собственный DeepSeek Harness, о выходе версии v0.2 которого мы писали 2 октября, в таблице не фигурирует.
Против Opus 5 и GPT-5.6 Sol
На DeepSWE v1.1 (обвязка Mini-SWE-V2) у 1017 77,0. У Opus 5 74,0, у GPT-5.6 Sol 73,0, у Kimi K3 67,5, у GLM-5.3 66,9. Opus 5 модель DeepSeek обходит ещё на трёх тестах: Automation-Bench (60,5 против 50,3), Agents’ Last Exam (35,4 против 28,6) и Apex Bench v1.1 (72,1 против 65,8).
На остальных семи из одиннадцати впереди Opus 5. Больше всего разрыв на HLE без инструментов, 56,3 против 42,6. Дальше Terminal-Bench 4.0 с обвязкой Claude Code (51,8 против 42,3), ProgramBench (37,0 против 29,1) и NL2Repo-Bench (75,3 против 68,2). На визуальных тестах с инструментами отставание небольшое: Chartography 83,0 против 84,0, BabyVision 92,5 против 94,1, ZeroBench-main 51,0 против 52,0. На ZeroBench лучший результат в таблице у GPT-5.6 Sol, 53,0. HLE без инструментов 1017 проигрывает и Kimi K3 (43,5), и GPT-5.6 Sol (44,5). GLM-5.3 там представлена только текстовым подмножеством: 42,0 против 44,0 у 1017. Визуальных результатов у GLM-5.3 в таблице нет.
Для сравнения внутри линейки: по данным Progressive Robot, флагман DeepSeek V4 Pro 0813 в своей карточке указывал 62,7 на DeepSWE. Версия теста там не уточнена, так что прямо сопоставлять с 77,0 стоит осторожно. Среди открытых моделей похожего класса Qwen3.8-Flash-Next от Alibaba, как мы писали 26 августа, набирала на DeepSWE 1.1 58,7.
Промпт без Jinja
Шаблона чата в формате Jinja в релизе нет. Вместо него в папке encoding лежит самодостаточный эталонный encoding.py с тестами на многоходовые диалоги, вызов инструментов, режим рассуждений, числовой уровень reasoning effort, системные сообщения посреди диалога и картинки вперемешку с текстом. Судя по всему, стекам инференса, которые берут шаблон из конфигурации токенизатора, форматирование промпта придётся подключать отдельно.
Для продакшена DeepSeek выпустила deepseek-recipe, набор библиотек на Rust с привязками для Python. Он принимает запросы в форматах Messages, Chat Completions и Responses API, переводит их в формат Conversation, кодирует в промпты или ID токенов для DeepSeek V4 и V4.1, а вывод модели разбирает обратно в полные или потоковые ответы, включая рассуждения, вызовы инструментов, изображения и параметры генерации. Сам инференс, выполнение инструментов и HTTP-транспорт остаются на стороне вызывающего кода.
Инструкции по конвертации весов и локальному запуску лежат в папке inference. Рекомендованные параметры сэмплирования: temperature 1.0, top_p 1.0, контекстное окно 1M токенов, max_tokens не меньше 256K.
Дальше
Anthropic принесла в Конгресс свой закон о безопасности ИИ
По данным Politico, представители Anthropic тихо обходят кабинеты Конгресса со своим проектом закона о безопасности ИИ. Остановить выпуск модели он разрешает лишь при риске ущерба больше 1 миллиарда долларов. Порог в 1 миллиард долларов ущерба вам кажется разумным или слишком высоким?
Читайте также
- Mistral Large 4 обошла GLM-5.3 на DeepSWE, пишет VentureBeat
- DeepSeek Harness v0.2 вышел без Linux, хотя его обещали
- У LFM2.5 от Liquid AI из 24B параметров работают 2B
- Дообучение MiMo-V2.6-Pro обошлось Xiaomi в 2,62 миллиона
- Переводчик Cohere не рассуждает, и это ради экономии
- Предшественник архитектуры Qwen4 вышел как 125B MoE
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.