
GPT-6 Astra набрала 66,7% против 43,8% у GPT-5.6 Sol
В одной из задач BioBasicsBench, нового бенчмарка, который OpenAI представила 6 ноября вместе с биотех-компанией Ligo, GPT-6 Astra разглядела на ободке контрольной чашки подпись «LB Kan50». На чашке был канамицин, хотя опыт шёл с ампициллином, и Astra отказалась считать её контролем, а GPT-5.6 Sol увидела пустую чашку без колоний и построила на ней вывод. На настройке xhigh Astra в среднем набрала 66,7% возможных баллов, GPT-5.6 Sol 43,8%, но это средняя доля баллов по рубрике, куда входят и частично верные разборы, и сама OpenAI оговаривает, что рост баллов пока не означает надёжных суждений в лаборатории.
Задачи собраны из рутинной работы мокрой лаборатории, где ставят опыты с биологическими образцами, и учёные писали их на данных собственных экспериментов. В OpenAI объясняют, зачем понадобился отдельный бенчмарк: повседневная работа в лаборатории полна неудачных опытов, нечётких снимков и противоречащих друг другу наблюдений, а существующие тесты строятся на графиках и изображениях, отобранных для научных статей, и могут эту неоднозначность упускать.
Что именно оценивают
Сто задач разбиты на пять областей: белковые методы, визуализация и цитометрия, количественные измерения и анализы, методы работы с нуклеиновыми кислотами, молекулярное клонирование. Диапазон от простых просьб вроде определить по гелю молекулярную массу образца ДНК до подробного разбора анализа. Агент получает сырые данные: гели и блоты встречаются в 31 задаче, протоколы, лабораторные журналы и сфотографированные рукописные заметки в 27, таблицы и выгрузки приборов в 20, микроскопия в 14, видео работы за столом в 7. В одной задаче бывает несколько видов данных, а в помощь даются справочные листы вроде карт плазмид и шкал маркеров.
Каждую задачу сначала проверял учёный Ligo, который её не писал, затем внешний рецензент уровня PhD из мокрой лаборатории, затем шла финальная внутренняя проверка. Рецензенты смотрели формулировку, исходные данные, рубрику, заметки автора и уже оценённую попытку модели.
Агент возвращает структурированный ответ: вывод, измерение или рекомендацию, а где нужно, и обоснование. Рубрика начисляет баллы по отдельным критериям, и в зависимости от задачи они касаются вывода, чисел, хода рассуждений или признания, что данных для вывода не хватает. Поэтому верный вывод и наполовину верный разбор получают разные оценки. Большинство задач проверяют несколько навыков сразу: биологические знания, чтение изображений и других данных, поиск ошибок и понимание протокола.
В посте в X OpenAI пишет, что бенчмарк показывает, где моделям нужно расти, и помогает следить, что эти улучшения значат для науки, биобезопасности и биозащиты.
Как читать 66,7%
OpenAI прогнала семь моделей в 37 сочетаниях модели и уровня рассуждений, по пять попыток на каждую из 100 задач, всего 18 500 результатов. Метрика - средний балл задачи в процентах от возможного. Доверительные интервалы 95% считали, многократно перевыбирая задачи целиком, вместе со всеми пятью попытками. Результаты на xhigh, самом высоком уровне, который есть у всех семи моделей:
- GPT-6 Astra: 66,7% (60,3-73,1%), 4 704 выходных токена на задачу;
- GPT-6.1 Sol: 62,0% (55,6-68,4%), 5 238;
- GPT-5.6 Sol: 43,8% (37,6-50,0%), 9 099;
- GPT-6 Luna: 38,3% (32,3-44,5%), 13 120;
- GPT-5.5: 35,4% (29,7-41,0%), 11 135;
- GPT-5.4: 33,2% (28,3-38,4%), 13 717;
- GPT-5.2: 31,2% (26,2-36,3%), 27 620.
Интервалы Astra и GPT-6.1 Sol на xhigh перекрываются, так что на этих 100 задачах их результаты уверенно не разделены. Отрыв Astra от GPT-5.6 Sol интервалами не размыт. При этом GPT-6 Luna из нового поколения на xhigh оказалась даже ниже GPT-5.6 Sol.
Astra, как утверждает OpenAI, обгоняет GPT-5.6 Sol даже на низком уровне рассуждений. В компании допускают, что ключом к рутинному лабораторному анализу может быть более сильная встроенная работа с изображениями и видео. Результаты на максимальном уровне, где он есть, OpenAI показала только на графике.
Что Astra видит и где ошибается
Помимо чашки с канамицином, OpenAI разбирает ещё два случая в пользу Astra. В первом GPT-5.6 Sol сочла клетки мёртвыми по свечению красителя SYTOX, но окна детекции двух каналов перекрываются на 525-540 нм, и детектор мог ловить свет второго красителя, FUN-1. Astra отметила эту неоднозначность и попросила контроли, которые разделят сигналы. Во втором клетки на серии снимков то появлялись в фокусе, то исчезали: GPT-5.6 Sol искала этому биологическое объяснение, Astra узнала z-стек, серию снимков на разной глубине.
Провалы Astra в том же разборе устроены похоже: привычное допущение, ожидаемый ответ или готовая подпись перевешивают сами данные, а верное промежуточное наблюдение не доходит до итогового решения. Модель отбрасывает наблюдения, которые противоречат предпочтительной для неё версии.
Нагляднее всего это видно на ПЦР колоний после клонирования. Astra правильно разделила полосы на две группы, но решила, что более крупный продукт ПЦР означает успешную сборку, и предложила колонии 4, 6, 7 и 8. Эталонный ответ, построенный на сравнении с контрольными дорожками, выбирает колонии 5, 9 и 10. Группы определены верно, но подписи к ним перепутаны, и в настоящей лаборатории дальше очистили бы не ту плазмиду.
Дальше
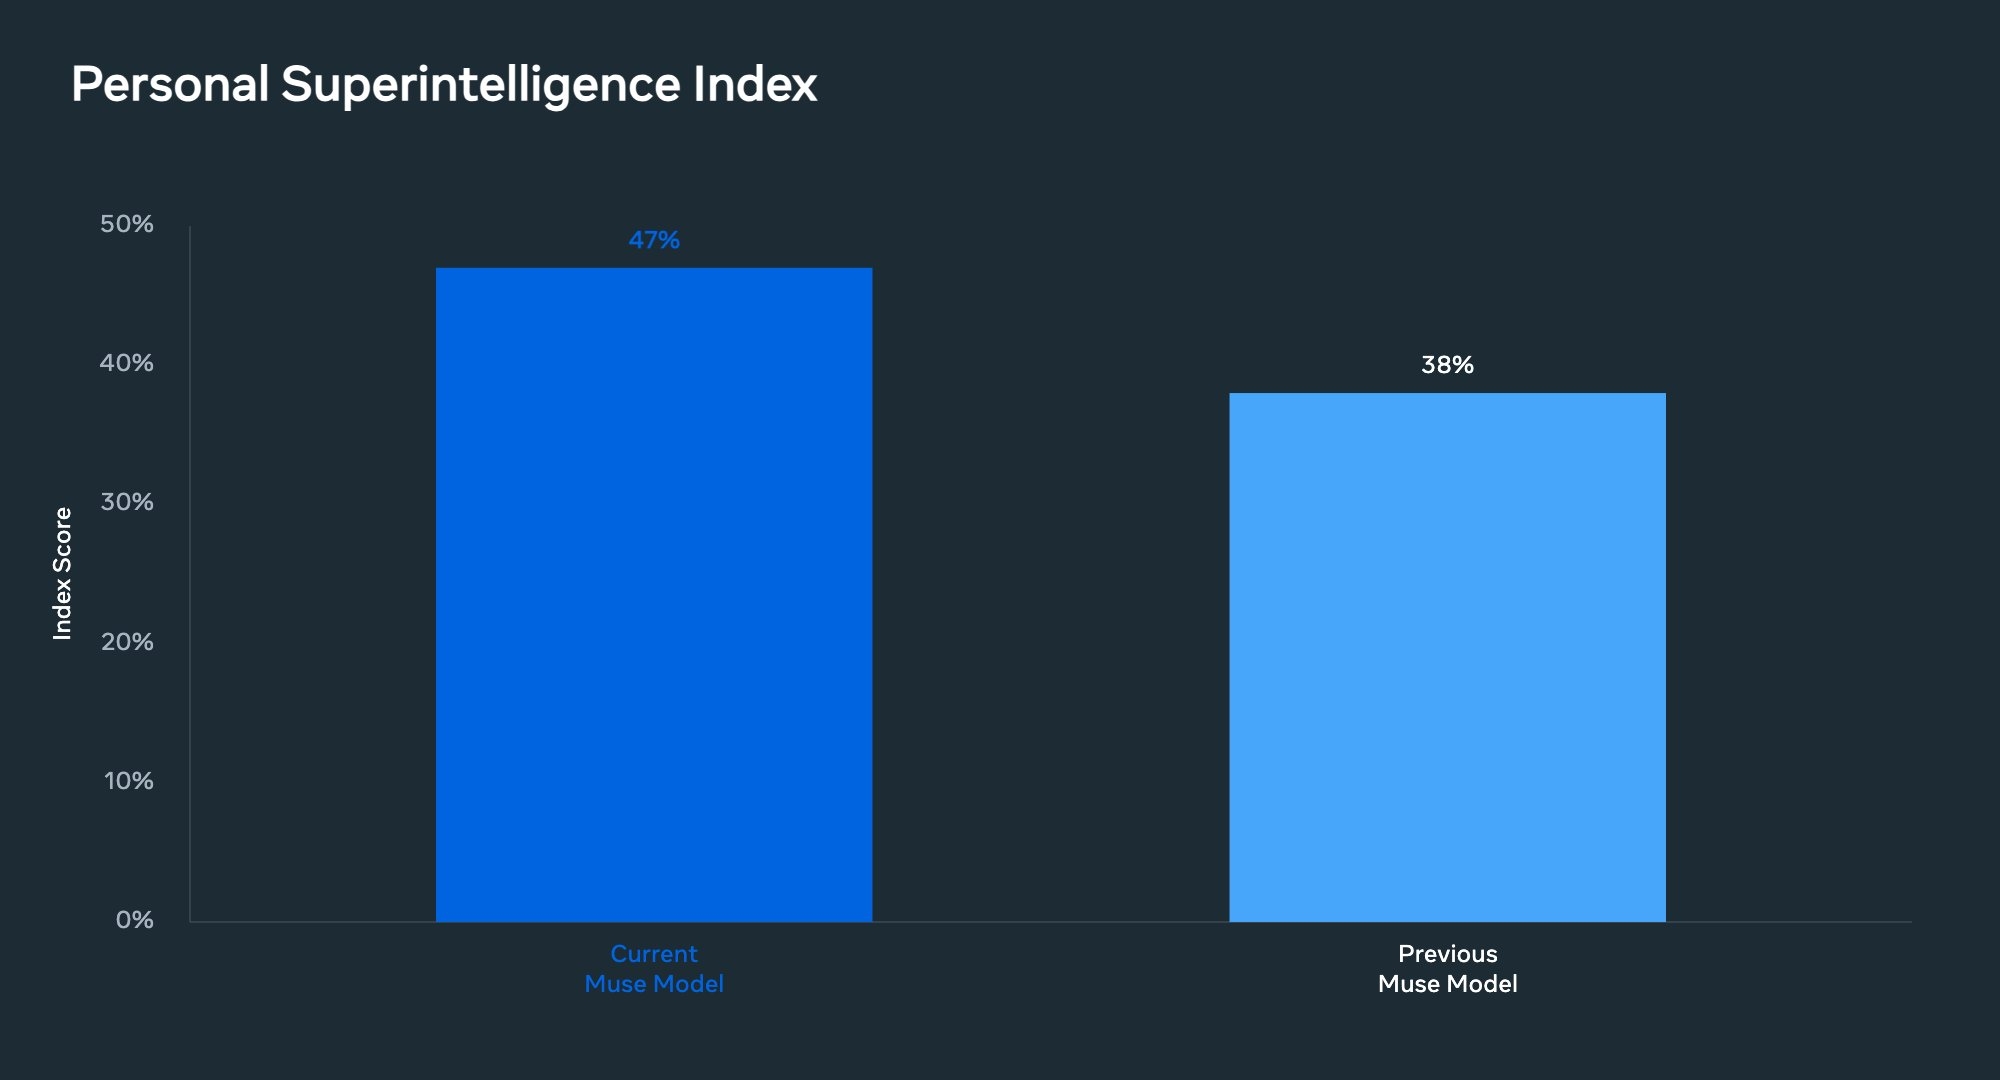
Meta AI и Muse перешли на модели, обученные Muse Wonder
«Отличать то, что ещё актуально, от того, что устарело», Meta научила этому модели в Muse и Meta AI с помощью флагманской Muse Wonder. На своём тесте памяти она насчитала 90% задач с верным контекстом против 76% раньше. Сколько раз за неделю вы напоминаете ассистенту то, что уже ему говорили?
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.