
MAI-Base-2 в 4–12 раз экономнее DeepSeek на предобучении
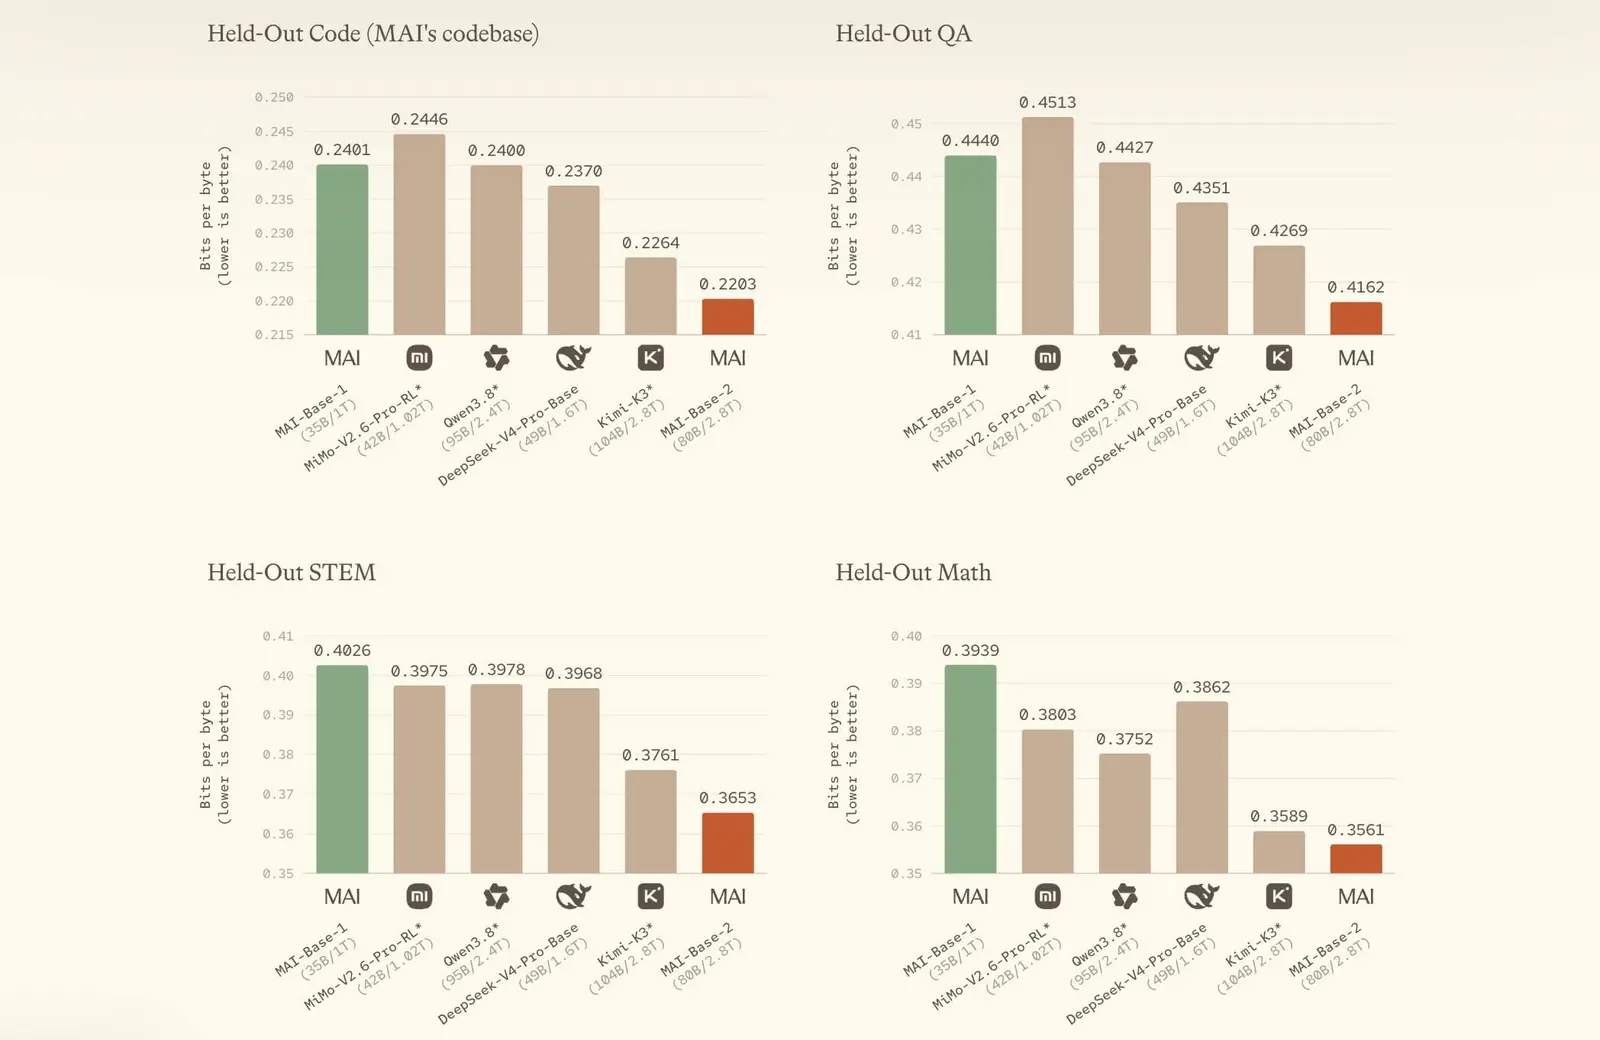
Microsoft AI посчитала стоимость своего оптимизатора с точностью до миллисекунд: на Muon при обучении MAI-Base-2 уходило 165 мс средней итерации, а теоретический предел команда оценивает в 55 мс. Эти цифры приводит блог Microsoft AI о предобучении.
Главное заявление там же. По словам Microsoft AI, MAI-Base-2 обходит все протестированные открытые модели на внутренних отложенных (held-out) оценках и в 4–12 раз эффективнее по FLOPs предобучения, чем DeepSeek-V4-Pro-Base, которую компания называет сильнейшей открытой базовой моделью. Сэкономленные вычисления, пишет Microsoft AI, ушли на обучение модели покрупнее. На первом графике MAI-Base-2 сравнивают только с моделями, у которых не меньше триллиона параметров в сумме, и там чем ниже значение, тем лучше. Как пишет Testing Catalog в Threads, предобучение MAI-Base-2 завершено.
Коротко
- Microsoft AI заявляет, что MAI-Base-2 в 4–12 раз эффективнее по FLOPs предобучения, чем DeepSeek-V4-Pro-Base; сравнение построено на собственных оценках компании.
- Вместо AdamW модель обучали с Muon, которому нужна целая матрица весов, поэтому момент на каждом шаге пересобирают между GPU и раздают обратно.
- В смеси экспертов (MoE) перегруженные эксперты берут свободную ёмкость соседей, а расход памяти не зависит от перекоса токенов.
- Обрезка градиентов по активациям вместе с Muon держит норму градиента MAI-Base-2 в куда более узком коридоре, чем у MAI-Base-1.
Хронология
Собственная базовая модель с подробным техническим разбором появляется на третьем году существования Microsoft AI. Шаги, которые к ней привели:
- 19 марта 2024: по данным Wikipedia, основана Microsoft AI, гендиректор Мустафа Сулейман, главный научный сотрудник Карен Симонян.
- 28 августа 2025: по данным Wikipedia, объявлены первые собственные модели MAI-Voice-1 и MAI-1-preview; до этого продукты обычно работали на моделях OpenAI.
- 6 ноября 2025: по данным Wikipedia, MAI объявила о подразделении и команде superintelligence под руководством Сулеймана.
- Март 2026: по данным Wikipedia, создано отдельное подразделение Copilot во главе с Джейкобом Андреу, а Сулейман остался курировать MAI Superintelligence.
- 2 апреля 2026: вышли MAI-Transcribe-1, MAI-Voice-1 и MAI-Image-2; Tech Insider назвал релиз самым явным на тот момент отходом от партнёрства Microsoft с OpenAI на 13 миллиардов долларов и первым крупным результатом команды MAI Superintelligence.
- 1 октября 2026: мы писали, что в API и MAI Playground готовятся MAI-Transcribe-2-Streaming, MAI-Voice-2.1 и MAI-Voice-2.1-Flash.
- 9 октября 2026: Microsoft-Decision-1 вышла на дообученной Qwen3.5-9B, и Microsoft обещала позже пересобрать её на других базах, включая MAI.
- 12 октября 2026: Microsoft объявила, что с 2027 года основной системой инференса для её продуктов станут собственные чипы Maia.
В этот раз речь о базовой модели, и Microsoft AI раскрывает, как устроено её обучение на уровне коммуникаций между GPU.
Muon обошёл AdamW, но потребовал пересобирать матрицы между GPU
При масштабировании до MAI-Base-2 Muon, по словам Microsoft AI, дал более стабильную динамику обучения и большой выигрыш в эффективности против AdamW. В документации Nvidia название расшифровано как MomentUm Orthogonalized by Newton-schulz, автором указана Moonshot AI; там же сказано, что Muon применяют к линейным слоям, а эмбеддинги и нормализацию оставляют Adam.
Muon ортогонализует момент каждой матрицы весов итерациями Ньютона–Шульца, то есть несколькими матричными умножениями подряд. Для этого нужна целая матрица, а ZeRO режет момент на куски по data-parallel измерению. Похоже на пазл, который нельзя проверить, пока все детали лежат в разных коробках.
Решение Microsoft AI описывает так. Каждый GPU обновляет свой кусок момента в FP32 и приводит его к BF16. Обмен all-to-all, сгруппированный по параметрам одинаковой формы, отдаёт каждому GPU набор целых матриц. Их ортогонализуют локально ядром Ньютона–Шульца, учитывающим симметрию. Второй all-to-all возвращает обновления на исходные куски, где их снова переводят в FP32 и применяют к весам.
Для обучения на 16K GPU добавили ещё три приёма. Коммуникации перекрываются с вычислениями за счёт предвыборки нескольких батчей. Метаданные пересборки кэшируются, что особенно выручает в разреженных MoE с тысячами параметров одинаковой формы. Отдельные веса, например веса роутера MoE, реплицируются на всех GPU вместо шардирования: первый обмен для них пропускают и после Ньютона–Шульца собирают обновления через all-gather.
Итог: 2,1% (165 мс) средней итерации MAI-Base-2. Теоретический предел для финальной конфигурации, 55 мс, упирается в коммуникации. Разрыв компания объясняет отстающими узлами, накладными расходами на запуск ядер, дисбалансом нагрузки и копированием и выделением памяти при пересборке.
Фрагмент блога упоминает, что пересборка момента сделана вслед за предыдущими работами, но не называет, какими. Из известных: статья Moonshot AI на arXiv от февраля 2025 года. По её данным, ключом к масштабированию Muon стали weight decay и аккуратное масштабирование обновлений по параметрам, а в экспериментах по законам масштабирования Muon дал примерно двукратную вычислительную эффективность против AdamW при compute-optimal обучении. Авторы обучили на нём Moonlight, MoE на 3B/16B параметров и 5,7T токенов, и открыли распределённую реализацию.
Второй стабилизатор касается градиентов. Обычная обрезка работает по глобальной норме градиента весов всего батча, и выброс, который дают немногие примеры, уменьшает вклад всех остальных. Microsoft AI вместо этого обрезает градиенты активаций в выбранных местах сети. Вместе с Muon это держит норму градиента MAI-Base-2 в заметно более узком диапазоне, чем у MAI-Base-1 (рисунок 7 в блоге).
Перегруженные эксперты занимают свободную ёмкость соседей
В MoE роутер отправляет каждый токен к нескольким экспертам, и нагрузка между ними почти никогда не ровная. Microsoft AI собирает экспертов на каждом ранге expert parallel в группы настраиваемого размера. Группа проходит раунды dispatch → compute → collect с фиксированной ёмкостью на эксперта, а лишние токены уходят в дополнительные раунды.
Чтобы раундов было меньше, перегруженный эксперт может забрать неиспользованную ёмкость соседей по группе. Обратный проход пересчитывает активации по той же схеме, и память остаётся статичной при любом перекосе. На практике ёмкость подбирают так, чтобы в устойчивом режиме хватало одного раунда.
Раунды всех групп идут конвейером, и открытыми остаются только первый dispatch и последний collect. В прямом проходе их закрывают квантование весов и вычисления общего эксперта, в обратном все коммуникации экспертов перекрыты полностью.
Накладные расходы на эксперта срезали группировкой GEMM и обменов по NVLink, метаданными токенов прямо на GPU с запуском all-to-all оттуда же, симметричной памятью для обмена без промежуточных копий и одной общей редукцией load-balancing loss по всем слоям. По словам компании, всё вместе даёт обучать более разреженные модели без заметной потери MFU, доли пиковой производительности GPU, которая уходит на полезные вычисления.
Чего мы не знаем
В материале нет размера MAI-Base-2: ни общего числа параметров, ни активных. Не описан состав held-out оценок, и не объяснено, от чего зависит разброс множителя от 4 до 12. Ничего не сказано и о доступности модели.
Инженерная часть блога расписана до миллисекунд и честно показывает трёхкратный разрыв с теоретическим пределом. Множитель 4–12 подан куда скупее: при разбросе в три раза на закрытом наборе оценок мы пока считаем его заявкой Microsoft AI, которую извне не перепроверить.
Следующий шаг в этой линии, по сообщению Testing Catalog в Threads, уже намечен: к циклу обучения MAI-Base-3 готовятся. Дат старта или выхода в материалах нет.
Дальше
Прокуроры: инженер OpenAI взял билет в один конец
Билеты в один конец до Саудовской Аравии, из Сан-Франциско через Стамбул на 12 октября. По данным Bloomberg, этим прокуроры объяснили суду, зачем засекретить дело инженера OpenAI. Задержали его за три дня до вылета.
Читайте также
- У Microsoft-Decision-1 выходные токены бесплатные
- MAI-Transcribe-2 получил потоковую версию для голосовых агентов
- Microsoft переводит свои ИИ-сервисы на собственные чипы Maia
- Диффузионная модель выдаёт 1 107 токенов в секунду
- Grok Voice 3.0 обошла GPT-Live-1 и Gemini 3.8 Live
- Модель выбора SubQ Snap берёт 384K токенов вместо 32K
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.