
Чтение в Habitat у OpenAI: около 10 мс вместо 120
Habitat, хранилище под продуктами OpenAI, снова работает на одном общем контейнере Azure Cosmos DB. Медианное чтение в нём за 2026 год ускорилось примерно в 12 раз: было около 120 мс, стало около 10 мс. Так выглядят итоги во второй части инженерного разбора OpenAI, опубликованной 23 октября.
Первая часть рассказывала, как Habitat из Python-библиотеки превратился в отдельный сервис. Вторая посвящена слою под ним. Habitat хранит больше 500 петабайт и отвечает пользователям в 40 регионах. Самый крупный аккаунт Cosmos DB у OpenAI держит десятки петабайт и обслуживает больше 20 миллионов запросов в секунду. В компании говорят, что больше никто, насколько им известно, не разворачивал Cosmos DB в таком масштабе.
Общий контейнер, отдельные и снова общий
Сначала немного о том, как устроена Cosmos DB. Контейнеру выделяют пропускную способность в RU/s (request units, условных единицах стоимости запроса). Данные шардируются по логическому ключу партиции, а база раскладывает эти ключи по меньшему числу физических разделов. Раздел делится, когда упирается в лимит объёма или когда контейнеру нужно больше разделов под выделенную пропускную способность.
На первом этапе все данные лежали в одном контейнере на аккаунт, а от перегрузки защищал заявленный лимит в 10 000 RU/s на логический ключ. Проблем нашлось три. Ключ партиции клиенты выбирали сами, поэтому разные продукты сталкивались на user_id и workspace_id и делили один лимит на пользователя. Лимит при этом фактически действует на уровне физического раздела, и шумный сосед (клиент, который выбирает непропорционально много ресурсов) тормозил все ключи, лежащие рядом. Бывало, что нагрузка от нишевой функции ломала вход и регистрацию. Третья проблема - слабые разделы: пропускная способность контейнера делится между физическими разделами примерно поровну, поэтому при каждом делении из-за роста объёма на один раздел приходится меньше. У самых тяжёлых по объёму данных, похожих на блобы, запас по пропускной способности сокращался от одного роста объёма, хотя трафик не менялся.
На втором этапе для критичных сценариев стали заводить отдельные контейнеры, а слабые разделы лечили скриптом, который подгонял выделенную пропускную способность под число разделов. Сайт падал реже, но вместе с общим контейнером пропал эффект смешивания нагрузки. В общем контейнере новая функция, выросшая с нуля до миллиона QPS, почти не сдвигала суммарную нагрузку. В отдельном контейнере такой рост мог означать нагрузку в тысячу раз выше той, что была на внутренних тестах: 1 000 RU/s на нагрузочном тестировании и 1 миллион RU/s в день запуска. Команды выкатывали функции и забывали заранее расширить контейнер, а потом в день запуска сидели на разборе инцидента и наращивали мощность в последний момент. Получилось, что мощности планировала почти каждая продуктовая команда OpenAI, и делали это очень по-разному.
Третий этап OpenAI построила вместе с командой Azure. Самые горячие ключи теперь ограничиваются первыми, чтобы один ключ не забирал весь раздел. Фоновые запросы (массовые вставки, выгрузки) получают низкий приоритет и при нехватке ресурсов режутся раньше интерактивных. А под OpenAI Azure доработала бессерверный режим:
- потолок физического раздела: 5 000 RU/s → 10 000 RU/s;
- деление разделов: только по объёму данных → по объёму и по расходу RU.
После этого Habitat вернулся к одному общему контейнеру, и следить за мощностью отдельных контейнеров вручную больше не нужно. За несколько месяцев с переезда, по словам компании, не было ни одного инцидента из-за провизионирования или шумных соседей. Правда, срок пока измеряется месяцами.
Как управляемый сервис перестал быть управляемым
Отношения с Azure поменяла авария конца 2024 года. В основном регионе одного из крупнейших аккаунтов отключилось электричество, и оказалось, что переключение самых больших аккаунтов на запасной регион занимает несколько часов. На таком масштабе этого не проверяла ни OpenAI, ни команда Cosmos DB. Примерно через месяц, при возврате в исходный регион, случился ещё один серьёзный сбой. Из-за особенности клиента Cosmos DB в режиме шлюза все клиенты разом пошли в исходный регион, хотя туда вернулась только часть физических разделов, и лавина подключений положила шлюз.
Теперь команды Habitat и Azure вместе мониторят все уровни, от сервисов OpenAI до физического хранения в Cosmos DB. Изменения проверяют на непроизводственном аккаунте размером с боевой, SDK дорабатывают совместно, а инженеры могут вызвать друг друга напрямую, без линий поддержки. За последний год в шлюз Cosmos DB добавили защиту от перегрузки и кэширование метаданных, со стороны OpenAI сократили число соединений от Python-процессов за счёт пулов, а критичные нагрузки отделили от фоновых разными VPC. «На масштабе управляемые сервисы становятся менее управляемыми», - формулирует OpenAI.
Откуда 10 миллисекунд
На чтение приходится больше 90% запросов к Habitat. Вычисления и хранилище часто находятся в разных регионах, и раньше продуктовые команды обходили задержку сами: кэшировали на клиенте, собирали запросы в пачки, выносили работу с критического пути. Продукты от этого усложнялись, хотя Habitat задумывался как раз затем, чтобы разработчикам не приходилось разбираться в базе.
Держать данные рядом с пользователями получается в основном там, где этого требуют правила о хранении данных: во многих регионах просто нет места под нужный объём. Иногда приходится выбирать, отдать мощность дата-центра под хранилище или под вычисления. Широко реплицируют только маленькие и самые чувствительные к задержке наборы данных, вроде метаданных аутентификации, которые нужны на каждый запрос. Часть аккаунтов копируется во все 40 регионов, часть хотя бы в один регион на каждом континенте.
Всё остальное закрывает кэш на серверах Valkey рядом с местом, где обрабатываются запросы. Короткий TTL снижает отдачу от кэша, длинный оставляет устаревшие данные, а ручная инвалидация при записи ломается на частичных сбоях. Поэтому OpenAI пошла по пути Meta с её TAO: отдельный сервис читает поток изменений (change feed) Cosmos DB и за секунды сбрасывает устаревшие записи в локальных кэшах по всему миру. Ещё часть задержки сняли, когда переписали сервис Habitat с Python на Rust.
Тот же механизм отслеживания изменений (CDC) обрабатывает миллионы изменений в секунду из тысяч контейнеров и миллионов партиций. Они идут больше чем в сотню топиков Kafka и питают вторичные индексы, переносы данных и аналитику. Под такой поток OpenAI пришлось переделать в CDC SDK от Azure механизм чекпоинтов: теперь они копятся в памяти и сбрасываются периодически. Хвост задержек остаётся: самые медленные запросы всё равно идут за некэшированными данными в далёкие регионы.
Своё хранилище на RocksDB
К следующему миллиарду пользователей OpenAI готовит собственное онлайн-хранилище эксабайтного масштаба под самые объёмные типы данных Habitat. Его строят на ядре RocksDB Cloud от Rockset с репликацией по Raft, а модель документов повторяет Cosmos DB. Хранение отделено от вычислений, реплицируются физические данные, и всё это ради меньшего расхода флеш-памяти ценой более низкого пикового QPS.
Дальше
SPACEXSI: Cursor научился управлять другими приложениями, Видео
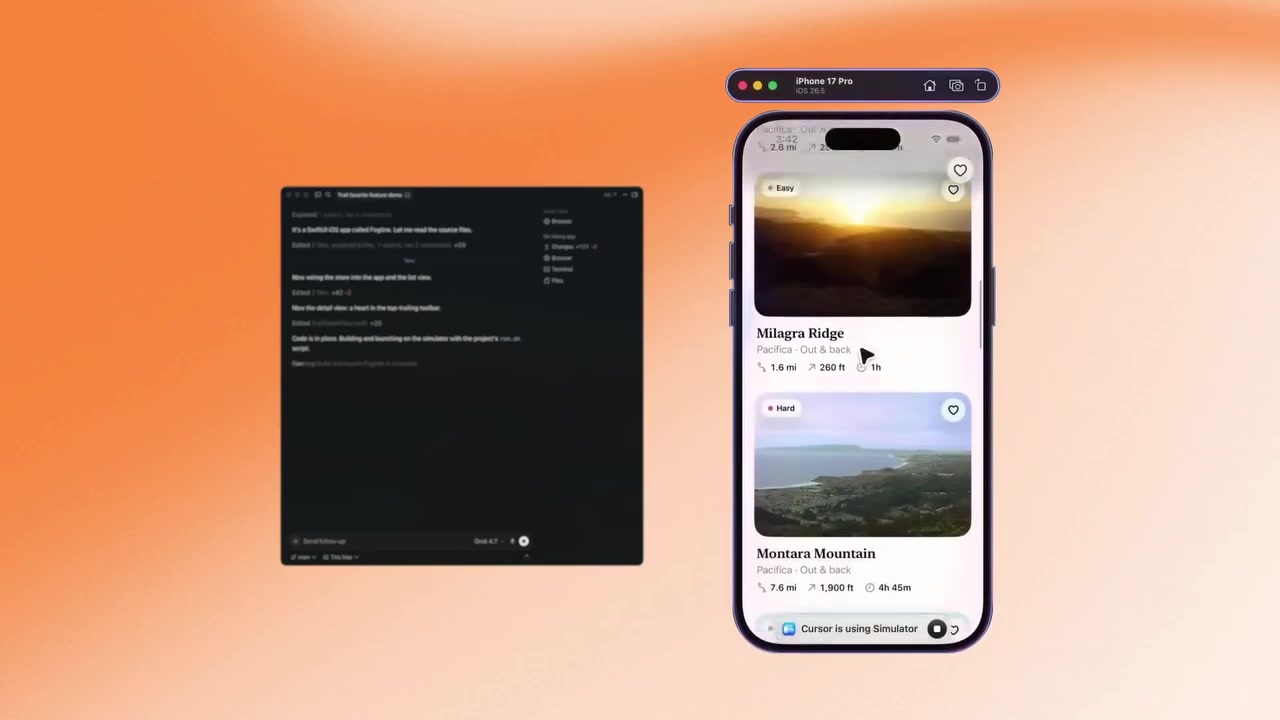
Cursor, по словам SPACEXSI, научился управлять другими приложениями на ноутбуке и даже запускать мобильные симуляторы. Включается это по запросу или упоминанием Computer Use через @. Вы уже пускали агента кликать по приложениям на своём рабочем ноутбуке?
Читайте также
- Как Python-библиотека OpenAI доросла до миллиарда
- OpenAI обвинила экс-сотрудника в выносе файлов в Apple
- Хо из OpenAI: 99,99% точности мало для чипа Jalapeño
- После 460 МВт Anthropic торгуется за площадки по 20–30 МВт
- Свои модели вывели чип OpenAI на 88,94% потолка за 40 часов
- Создателей портретного режима iPhone купила OpenAI
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.