
Хо из OpenAI: 99,99% точности мало для чипа Jalapeño
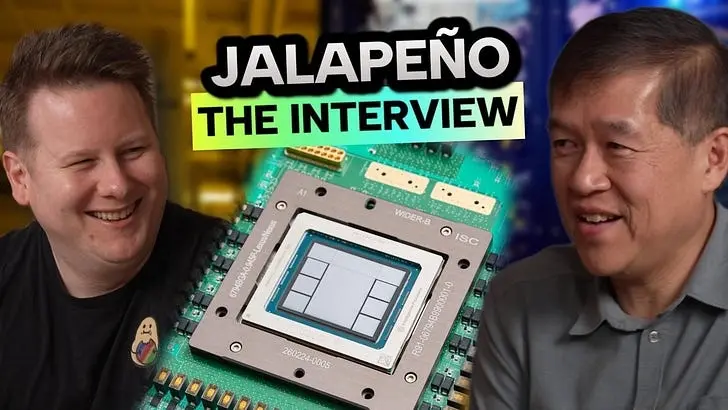
Одна реализация attention на чипе Jalapeño примерно за сорок часов оптимизации выросла с менее чем 1% теоретического потолка по памяти и вычислениям почти до 90%. Ричард Хо, один из первых участников аппаратного проекта OpenAI, в интервью More Than Moore на Substack рассказал, как модели компании помогали проектировать ускоритель и почему последнее слово всё равно остаётся за классическими инструментами проверки.
Коротко
- В июне 2026 года OpenAI подтвердила, что вместе с Broadcom делает собственный ускоритель инференса Jalapeño, а на HotChips 2026 впервые показала замеры работающего кремния против NVIDIA GB200 и GB300.
- У чипа 216 GiB памяти HBM4 с пропускной способностью 15,4 ТБ/с и пиковое потребление 700 Вт, а система из 2 048 ускорителей выдаёт 27 EFLOP/s при четырёхбитной точности.
- Модели помогали проектировать и оптимизировать чип, но Хо не доверяет им до конца: смысл части их правок инженеры сначала не поняли, поэтому дизайн проходит стандартную сверку в EDA.
Если вы не следили за Хо, вот его путь. Он начинал младшим инженером в многопроцессорном проекте Джона Хеннесси в Стэнфорде, защитил диссертацию по верификации и основал EDA-стартап. Потом строил суперкомпьютеры Anton в D. E. Shaw Research и стал одним из первых инженеров TPU в Google, где застал семь или восемь поколений чипов. После недолгой работы над кремниевой фотоникой в Lightmatter он в 2023 году пришёл в OpenAI.
По замерам OpenAI, Jalapeño в 1,5–1,9 раза эффективнее GB200/GB300 на ватт при пиковой пропускной способности
Jalapeño задуман как ускоритель инференса, а не обучения. В корпусе стоят вычислительный кристалл, чиплет ввода-вывода и 216 GiB HBM4 с пропускной способностью 15,4 ТБ/с. Пиковое потребление 700 Вт, замеренное устойчивое ближе к 550 Вт. Проектировать помогала Broadcom, платы и стойки собирает Celestica.
Локальный домен объединяет 128 ускорителей, полная система 2 048, и при четырёхбитной точности она выдаёт 27 EFLOP/s. На HotChips 2026 Хо, Рави Нараянасвами и Крис Лири сравнили чип с NVIDIA GB200/GB300: производительность на ватт при пиковой пропускной способности выше в 1,5–1,9 раза, задержка лучше в 1,7–3,6 раза, а в режимах, которые NVIDIA, по версии OpenAI, выдерживает с трудом, разрыв доходит до 104 раз.
Чип вернулся с производства примерно в середине мая, и к докладу готовились в спешке. Замеры сделали на стороннем бенчмарке InferenceX с опубликованной методикой и трёх открытых моделях разного размера, по словам Хо, чтобы к цифрам не было претензий. Черновые модели для спекулятивного декодирования сделать не успели, поэтому Jalapeño шёл в режиме предсказания одного токена (STP) против опубликованных результатов с предсказанием нескольких токенов (MTP) и, по словам Хо, обогнал их.
Один чип на весь инференс, хотя остальной рынок делит prefill и decode по разному железу
Другие производители раскладывают инференс по специализированному железу: prefill, то есть обработка входного запроса, спекулятивное декодирование и полное декодирование идут на разных чипах. OpenAI сделала одну сбалансированную микросхему для всех этапов и однородный дата-центр. Готовя доклад для HotChips, команда сама считала этот тезис самым спорным.
Хо смотрит на весь парк: при разделении железа пропорцию приходится фиксировать заранее, вкладывая под неё капитальные затраты и мощность, а пропорции сильно меняются. Универсальный чип можно перебрасывать между задачами, а цену за универсальность, по словам Хо, пока выявить не удалось, хотя в реальном развёртывании она может проявиться. CPU и GPU в парке останутся, его беспокоят лишь кластеры, жёстко привязанные к одной задаче.
Почему в Jalapeño каждое ядро работает со своим банком HBM
У NVIDIA несколько SM, то есть вычислительных блоков, работают через общий кеш L2, и любой из них может обратиться к данным в едином пространстве памяти. В Jalapeño банки HBM закреплены за конкретными ядрами: пока задача помещается в пару «ядро плюс свой банк», данные никуда не перемещаются. Кольцевая шина между ядрами есть, но основная работа идёт по быстрым локальным каналам.
Представьте кухню, где у каждого повара под рукой свой холодильник вместо общего склада в конце коридора: бегать меньше, зато меню нужно заранее распределить между поварами. Такая схема с неоднородным доступом к памяти (NUMA) усложняет программирование, и вопрос был в том, удастся ли разложить на неё реальную нагрузку. По словам Хо, пока это получалось со всеми открытыми моделями, которые пробовали.
Хо ожидает, что NUMA начнут копировать в своих чипах, возможно, даже производители GPU. Рассказать об этом открыто, по его словам, решили, потому что OpenAI по-прежнему нужны GPU и компания хочет, чтобы они становились лучше.
Внутренние модели без дообучения сэкономили больше 13% площади кристалла
К моделям обратились, когда выяснилось, что логика, заложенная в симуляции, не помещается на отведённую площадь. Внутренние модели OpenAI без дообучения в одном случае сэкономили больше 13% площади. Хо объясняет это тем, что модель держит в контексте весь чип сразу и видит слабые места, которые человеку трудно связать между собой.
Сильно помог XLS, инструмент высокоуровневого синтеза, который Крис Лири написал и выложил в открытый доступ ещё в Google. Синтаксис у него в духе Rust, а Verilog модели тогда понимали плохо, поэтому оптимизированные участки написаны в основном на XLS. Модели помогали и с оптимизацией программных ядер под готовое железо.
Дизайн насчитывает порядка 300 миллионов вентилей, и модель, которая права на 99,99%, для отправки в производство не годится, говорит Хо, поэтому финальную проверку проводят стандартные EDA-потоки. Когда модели переписали часть исходного кода, инженеры сначала не поняли зачем, а разбираться было некогда. Страховкой служит полная валидация.
Замеры делали в спешке, в режиме STP и на открытых моделях, которые в продакшене на Jalapeño не работают, тогда как сама OpenAI использует MTP, а устройство вычислительного движка компания не раскрыла. Хо признаёт, что на очень длинных контекстах привязка памяти к ядрам может упереться в предел, и такой анализ ещё не проводили. На наш взгляд, для чипа, который должен в одиночку обслуживать весь инференс, непроверенная работа с длинным контекстом выглядит заметным пробелом.
Что покажет ревизия B0
Переход от первой ревизии A0 к B0 OpenAI планировала с самого начала, ошибки в A0 тут ни при чём. Сейчас B0 проходит квалификацию в лаборатории, после чего начнётся наращивание объёмов; сроки серийных поставок в интервью не названы. В дорожной карте есть второе и третье поколения с новыми архитектурными идеями, а из новых бенчмарков Хо допускает AgentX, если найдётся время.
Читайте также
- Свои модели вывели чип OpenAI на 88,94% потолка за 40 часов
- OpenAI проектировала Jalapeno от задержки, а не от флопсов
- После 460 МВт Anthropic торгуется за площадки по 20–30 МВт
- Создателей портретного режима iPhone купила OpenAI
- Как Python-библиотека OpenAI доросла до миллиарда
- Ядра в Gluon пишет ИИ, инженеры их не читают
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.