
OpenAI нашла 948 путей к root в ядре Linux
Конвейер ИИ-агентов OpenAI на ещё не выпущенной кибермодели прошёл свежее ядро Linux и выдал 948 уникальных эксплойтов, с которыми непривилегированный локальный пользователь получает root, рассказано в посте OpenAI от 4 ноября. Исправления приходят в основную ветку ядра частями: к концу 10-дневной работы 61 уязвимость уже закрыли, для 43 патчи лежали в staging, ещё 299 разбирали публично, а остальное OpenAI вместе с партнёрами Patch the Planet отправляет постепенно, так что патчи из этого прогона будут появляться в upstream и после этих цифр.
Закрытие в upstream доходит до серверов через дистрибутивы, а там бывает разрыв. В октябре исправление для дыры CVE-2026-98432, которую модель Anthropic превратила в удалённый root-эксплойт, Debian выпустила 16 октября, а Ubuntu и Red Hat к концу месяца его ещё не выпустили. Сама OpenAI пишет, что темп раскрытия и исправлений делает своевременные обновления критически важными для пользователей и компаний.
Сканировали master-ветку ядра в середине октября 2026 года. Все 948 случаев - локальное повышение привилегий (LPE): атакующему нужен доступ к машине под обычной учётной записью. Перед отправкой мейнтейнерам эксплойт, патч и предложенную критичность смотрели исследователи-люди, а начать с критических уязвимостей, как пишет OpenAI, посоветовало сообщество ядра; сотни отчётов с патчами уже ушли.
Рост виден по трём точкам. В июне GPT-5.5 Cyber в рамках Patch the Planet написала 24 таких эксплойта, в конце июля GPT-5.6 Sol нашла и проэксплуатировала 166 уникальных LPE, в октябре новая модель дошла до 948.
Как читать 948
Рабочих LPE-эксплойтов агенты написали больше, 1 169. После анализа вариантов одной и той же ошибки их свели к 948 отдельным патчам, и именно по числу патчей OpenAI считает уникальные уязвимости.
Воронка начиналась широко. Агенты-разведчики отобрали 5 034 цели для аудита, около 2,8 млн строк, примерно 7% кода ядра, с упором на то, что достижимо для пользователя с низкими правами. Агенты-аналитики за 12 часов выдали 2 308 кандидатов после дедупликации. Затем агент сортировки писал для каждого proof-of-concept и гонял его в изолированной виртуалке с ядром под KASAN, отладочным детектором порчи памяти, пока не воспроизводил поведение или не исчерпывал способы его вызвать. За 30 часов подтвердились 1 724 уязвимости, 74,7% кандидатов. Большая часть остальных требовала повышенных прав или не воспроизвелась за отведённое время из-за трудных гонок и редких условий; ошибкой анализа модели, когда отчёт опирался на невозможное условие, оказались 3,1%.
Эксплойты проверяли в виртуалках с защитами, которые включены в стандартном дистрибутиве, в том числе SMEP и SMAP, чтобы результат не держался на отключённых механизмах. Кроме 1 169 LPE агенты собрали 291 рабочий proof-of-concept для утечек информации.
Сколько стоил прогон
Весь октябрьский прогон обошёлся в 1 213 430 долларов API-кредитов. Почти две трети пришлись на стадию эксплуатации, 775 929 долларов; поиск кандидатов стоил 316 549, проверка 73 330. OpenAI оговаривается, что мерила возможности моделей, а не экономию, и считает свои цифры скорее верхней границей. В пересчёте на уникальный LPE июльский прогон на GPT-5.6 Sol (513 690 долларов за 166 штук) вышел примерно в 3 100 долларов за уязвимость, октябрьский - примерно в 1 280.
Средний успешный эксплойт стоил 359 долларов, а Pwn2Own и TyphoonPWN исторически платили за LPE в ядре Linux 20 000 и 70 000 долларов. По этим ставкам OpenAI оценивает 948 эксплойтов гипотетически в 18,9-66,3 млн долларов, в 16-55 раз дороже прогона.
Отдельно конвейер пустили на окружение Google kernelCTF, где ядро усилено и поверхность атаки урезана. Одну защиту, SLAB_VIRTUAL, пришлось убрать из конфигурации: она несовместима с последней версией ядра. За 112 часов и примерно 32 936 долларов агенты получили 21 LPE-эксплойт и 25 proof-of-concept утечек, причём 83,7% затрат ушло на поиск уязвимостей. Для сравнения, в 2026 году kernelCTF на момент публикации принял 26 подтверждённых LPE-эксплойтов нулевого дня. Если бы программа приняла все 21, выплата составила бы около 1,5 млн долларов, примерно в 45 раз больше затрат.
Что перенять для своего конвейера
Тем, кто строит похожий поиск уязвимостей на агентах, OpenAI предлагает выводы, каждый со своим поводом:
- Проверять путь к результату вместе с самим результатом. В раннем прогоне из 200 «успешных» LPE 20 получили root через другой 0-day, не через назначенный. После этого задачу сузили и добавили независимую проверку, что эксплойт использует именно свою уязвимость.
- Ставить условие остановки. 69 неудачных попыток эксплуатации стоили в среднем по 3 922 доллара, в основном из-за немногих трудных случаев вроде гонок; остановка после часа без прогресса, по оценке OpenAI, заметно удешевила бы эту стадию.
- Перепроверять находки на свежем коде перед отчётом. Ядро патчат быстро, и повторная проверка, включая код, влитый после скана, отсекает дубли и устаревшие отчёты.
- Пересканировать уже проверенный код новыми моделями: более сильная модель находит то, что пропустила предыдущая, даже с той же обвязкой.
- Пересматривать обвязку при смене модели. GPT-5.5 Cyber с библиотекой из 103 техник эксплуатации подняла долю успехов на 63 кандидатах с 76,2% до 88,9%. GPT-5.6 Cyber без библиотеки обошла этот вариант, а с ней прибавила только 1,5 процентного пункта.
- Гонять модели в роли противника для ревью патчей, своих и человеческих. Первые патчи модели закрывали proof-of-concept, но порой тянули лишний код, расходились с принятым стилем или пропускали варианты той же ошибки; итерации это исправили, а в нескольких случаях прототип нашёл проблемы в патчах экспертов до слияния.
- Проверять саму тестовую инфраструктуру. В прогоне kernelCTF агент наткнулся на падение, отследил его до QEMU TCG без доступа к исходникам QEMU, и затем для этой уязвимости написали LPE-эксплойт; в upstream QEMU её уже исправили, но в релизной сборке эксперимента нет.
Десять новых техник
Из 166 разобранных эксплойтов агенты применили 10 техник эксплуатации, которые, насколько знает OpenAI, новы, и сторонние эксперты по эксплуатации ядра тоже их не знали. Две из них - новые объекты для распыления в кэше ядра, две улучшают надёжность за счёт раскладки страниц памяти, пять дают повышение привилегий через одни данные, без перехвата управления, ещё одна построена на произвольной путанице типов. Полные технические детали OpenAI из соображений безопасности не публикует.
Дальше
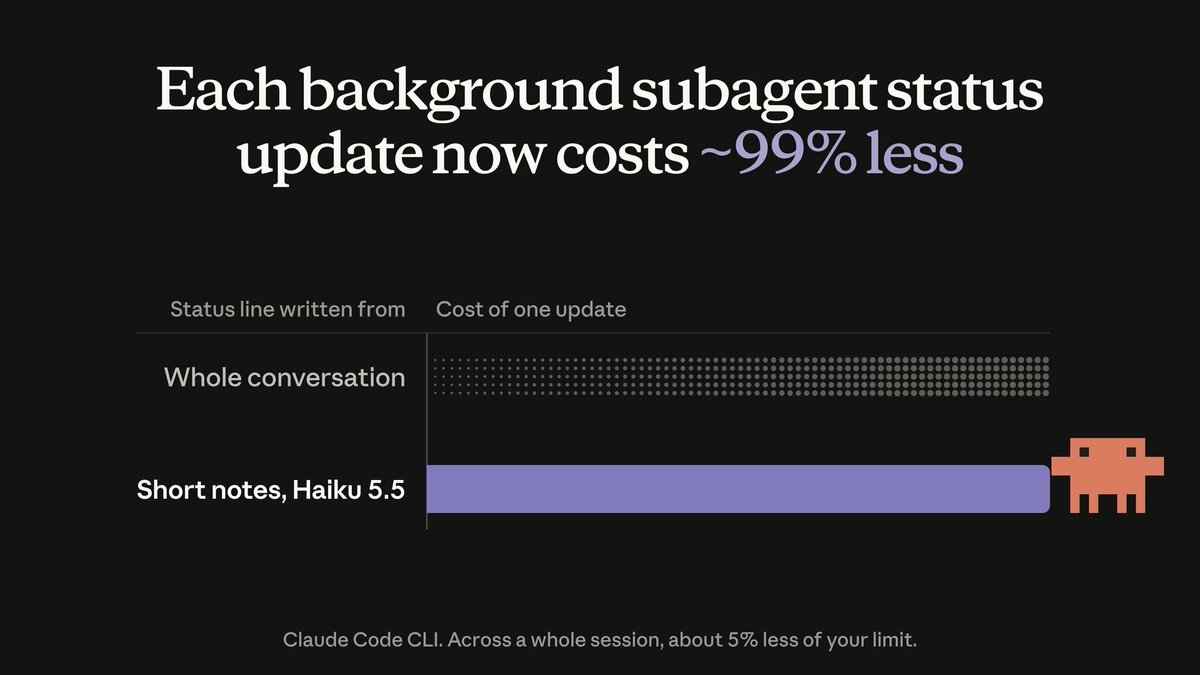
Субагенты Claude Code в фоне экономят около 5% лимита, Видео
Статусную строку фоновых субагентов в Claude Code отдали Haiku 5.5, и каждое её обновление подешевело примерно на 99%. Но на лимит всей сессии это даёт около 5% экономии. Вы держите субагентов в фоне или ждёте, пока каждый закончит?
Читайте также
- Модель Anthropic превратила баг ядра Linux в удалённый root
- Модели OpenAI помогли найти критические уязвимости в PHP
- OpenAI представила инициативу Patch the Planet
- Мониторы OpenAI в повторе сработали за 30 часов до взлома
- METR нашла способы отключить надзор за агентами OpenAI
- Сотни миллиардов токенов ушли на взлом инфраструктуры OpenAI
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.