
Claude Fable 5.1 пишет комментарии даже под запретом
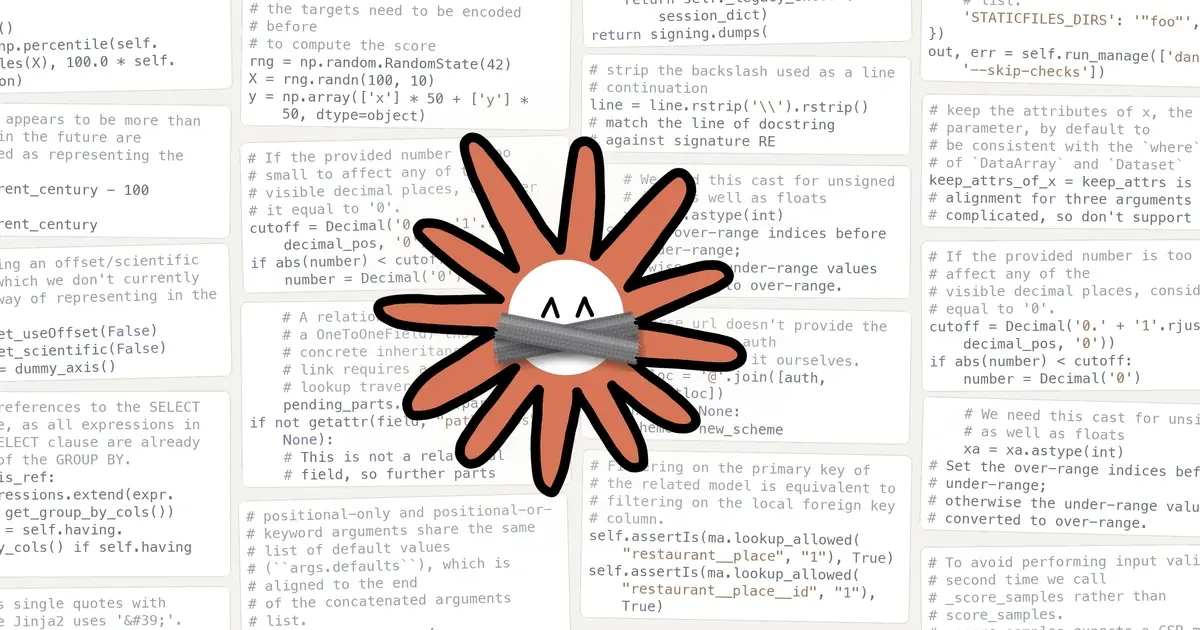
Claude Fable 5.1 добавил новый комментарий или докстринг в 33 задачах из 100, хотя системный промпт прямо это запрещал. Такой результат дал прогон «Shut up and SWE-bench», который автор блога Bayes опубликовал 24 сентября. Задачи Fable 5.1 решает чаще остальных, 86%, но в общем зачёте, где задачу надо решить и не оставить новых комментариев, GPT-6 Astra набрал 76% против его 59%, и запрет в промпте, судя по этому быстрому замеру одного автора, лишние комментарии от Claude не отсекает.
Как считали
Началось всё с личного опыта. В глобальном AGENTS.md автора, всего на 769 слов, есть два правила: не добавлять комментарии и документацию без явной просьбы и не трогать существующие комментарии, если правка не сделала их неверными. Claude, которым он в последнее время пользуется чаще всего, их регулярно нарушает. «Довольно удивительно, что у таких мощных моделей следование инструкциям всё ещё может быть настолько плохим», - замечает он и сразу оговаривается, что это лишь его впечатление.
Для проверки он взял 100 случайных задач из 261, которые разметчики SWE-bench Verified оценили в срок от 15 минут до часа. Самые короткие задачи он исключил: в исправлении на одну строку для комментария мало места. К системному промпту из inspect_evals дописаны те же два правила, только исключение звучит как «если issue прямо об этом не просит». Issue комментариев почти никогда не просят.
Комментарии ищет скрипт. Каждый изменённый .py-файл он прогоняет через модуль tokenize до и после правки, собирает комментарии и докстринги и считает добавленным текст, которого в старой версии не было. Перенесённый комментарий не засчитывается. Переписанный старый скрипт помечает, но такие случаи потом отбрасываются: комментарий, рядом с которым в том же фрагменте диффа удалена похожая строка, и докстринг, где новых строк меньше половины. В итоге считаются только новые комментарии.
Три модели в цифрах
- Claude Fable 5.1: решил 86% задач, обошёлся без новых комментариев в 67%, общий счёт 59%.
- GPT-6 Astra: решил 80%, без новых комментариев 94%, общий счёт 76%.
- Gemini 3.8 Flash: решил 76%, без новых комментариев 67%, общий счёт 55%.
Стандартная ошибка, по словам автора, около 5 процентных пунктов. Отрыв Fable 5.1 от GPT-6 Astra по решённым задачам составляет 6 пунктов и сопоставим с этой погрешностью. По доле задач без новых комментариев разница 27 пунктов в пользу Astra.
Gemini 3.8 Flash тоже оставил новые комментарии в 33 задачах. У GPT-6 Astra такие задачи составили 6%, и автор относит их к шуму своих наспех собранных эвристик: все шесть комментариев кажутся ему уместными. Один из пойманных случаев выглядит так: четыре строки над условием объясняют, почему в легенде не нужны смещение и научная нотация, и рассуждают, что когда-нибудь это может стать опцией.
Перефразы и память
Ещё в 6 задачах Fable 5.1 только переписывал существующие комментарии или докстринги, и в счёт они не попали. Автор просмотрел их вручную: в 5 из 6 правка была законной, потому что исправление делало старый текст неверным или добавляло параметр, который докстрингу нужно было перечислить.
Модели могли и запомнить задачи, как это бывает с самим SWE-bench. В одной задаче Django модель Fable добавила блок комментариев на семь строк, слово в слово совпадающий с комментарием из настоящего исправления в репозитории Django.
Если правила лежат в AGENTS.md
Правило в файле и раньше держалось не всегда: в июле для CLAUDE.md насчитывали около 12% нарушений, которые доходят до прода. В эксперименте Bayes запрет стоял прямо в системном промпте, поэтому вопрос, прочитал ли агент файл с правилами, там не возникал.
В самом Claude Code он возникает. Нативная поддержка AGENTS.md появилась в версии 2.1.277 от 18 сентября, и, как разбирает Даниэль Скантлинг, по умолчанию Claude Code читает либо AGENTS.md, либо CLAUDE.md. На Amazon Bedrock, Vertex AI, Microsoft Foundry и в сессиях с отключённой телеметрией читается только CLAUDE.md. Если CLAUDE.md лежит в рабочей папке или выше, запреты из AGENTS.md до модели не дойдут, пока CLAUDE.md не импортирует его строкой @AGENTS.md или пока в /config → Project instructions не выбран режим claude-md-and-agents-md.
Дальше
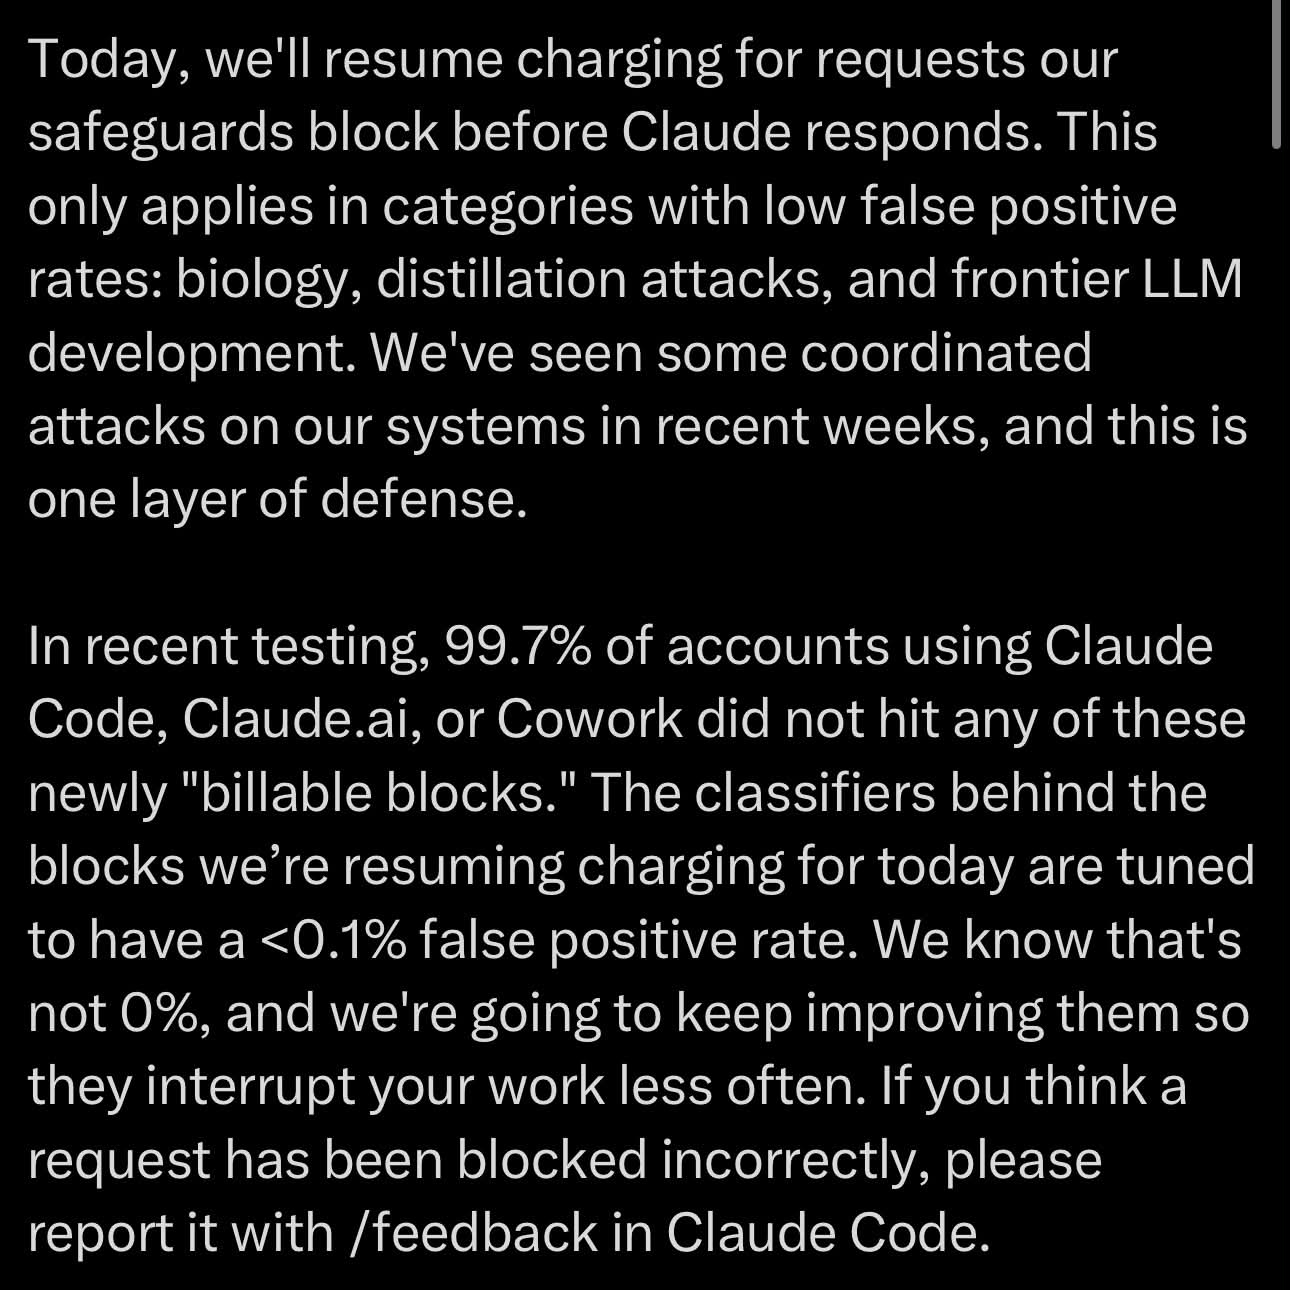
Anthropic снова берёт деньги за отклонённые запросы
Кто-то засыпает Claude вопросами про биологию или разработку LLM, фильтр режет их до ответа, а счёт всё равно приходит. Так Anthropic отвечает на скоординированные атаки последних недель.
Читайте также
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.