
benchmarks
Смена обвязки удвоила счёт при той же точности
Promtime
 benchmarks
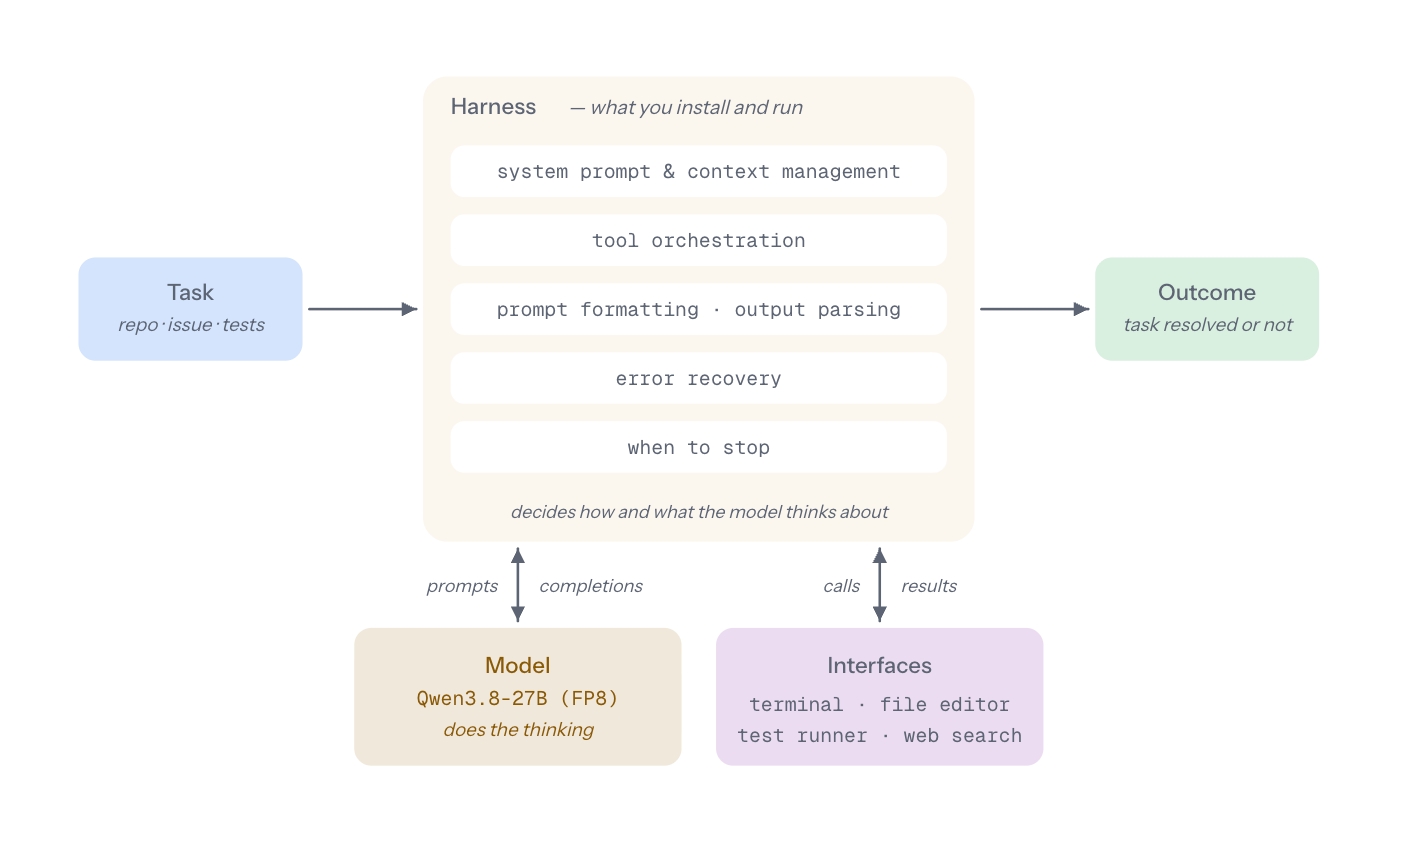
Команда aistack (imec) сравнила три обвязки кодовых агентов, Claude Code, Codex и Pi, на 64 задачах из SWE-Bench Pro и на двух моделях: доля решённых задач у всех шести комбинаций уложилась в 44–53%, а полный прогон на GLM-5.3-Flash через Codex стоил 22,8 доллара против 45 долларов у Claude Code и Pi.
Результаты опубликованы в блоге aistack (imec). Все три обвязки запускались с настройками по умолчанию и без кастомизации, а конфигурация инференс-движка оставалась одинаковой во всех прогонах. Обе модели работали в FP8: Qwen3.8-27B на одной NVIDIA H200, GLM-5.3-Flash на четырёх, ранее эта модель была известна как Ox alpha.
Коротко
- При одинаковой конфигурации инференс-движка и конкурентности 8 Codex на Qwen3.8-27B занимал в среднем 22,2% пула KV-кеша, Pi 24,6%, Claude Code 32,4%, при пике 59,8, 72,1 и 78,8%.
- На Qwen3.8-27B разница в цене невелика: 9 долларов через Codex, 10,26 через Claude Code и 10,16 через Pi при часовой ставке 4,54 доллара за одну H200 у Modal.
- В версии Claude Code 2.1.233 сломалось кеширование префикса: средняя доля попаданий упала до 29,84% против 97,36% на исправленном релизе, то есть обновление обвязки способно заметно изменить счёт.
Выбор обвязки до сих пор делается по популярности на GitHub и обсуждениям в соцсетях, тогда как измеримая часть решения лежит в инфраструктуре. Для команд, которые арендуют или покупают GPU, счёт формирует не точность модели, а время, в течение которого воркер занимает слот. Судя по замерам, при собственном стеке смена обвязки выглядит более дешёвым рычагом оптимизации, чем смена модели, и требует пересмотра при каждом обновлении.
Разброс в точности между обвязками составил две-три задачи из 64
На Qwen3.8-27B в FP8, который помещается на одну H200, Claude Code решил 33 задачи из 64 (52%), Codex 31 (48%), Pi 28 (44%). На GLM-5.3-Flash на четырёх H200 больше всех решил Codex, 33 задачи (52%), у Claude Code и Pi по 32 (50%). Обвязки выбирали по популярности в агентском кодинге и по тому, чем пользуются разработчики команды.
Каждый разработчик в тестовом фреймворке представлен отдельным воркером обвязки с собственным окружением, ресурсами и доступом в интернет. Бенчмарк из 64 задач команда собрала из SWE-Bench Pro ещё для первой статьи серии. По оценке Artificial Analysis, Qwen3.8-27B набирает 52 балла в Intelligence Index и 51 в агентском индексе.
Codex на GLM-5.3-Flash прокачал 192 млн входных токенов против 480 млн у Claude Code
На GLM-5.3-Flash Codex прогнал через модель 192,1 млн входных токенов за свип из 64 задач, Claude Code 480,2 млн, Pi 366,4 млн. На Qwen3.8-27B разрыв меньше: 330,5 млн у Codex, 445,8 млн у Claude Code и 348,5 млн у Pi.
Выходных токенов Codex на GLM-5.3-Flash сгенерировал около 2,1 млн против 3,97 млн у Claude Code и 3,79 млн у Pi. На Qwen3.8-27B все три обвязки уложились в 3,33–3,72 млн: 3,33 млн у Codex, по 3,72 млн у Claude Code и Pi.
Полный свип на GLM-5.3-Flash Codex прошёл за 1,26 часа реального времени против 2,48 часа у Claude Code и Pi, что даёт 50,5 задачи в час и 26 решённых задач в час; у Claude Code 25,8 и 12,9, у Pi 25,9 и 12,9. На Qwen3.8-27B разброс уже: от 2,07 часа у Codex до 2,26 часа у Claude Code.
Счёт считается по реальному времени работы GPU, 4,54 доллара в час за одну H200 и 18,16 доллара за четыре
Стоимость свипа команда считала как реальное время работы GPU, умноженное на часовую ставку Modal. В aistack отмечают, что генерация выходных токенов занимает заметную долю общего времени прогона, из-за чего сессия дольше удерживает GPU-слот. По расчётам команды, тот же объём работы по ценам API Anthropic обошёлся бы примерно в 98 долларов.
Отдельная проблема возникла у Pi: один-два воркера регулярно уходили в бесконечный цикл и генерировали повторяющийся текст, пока оркестратор не снимал их по лимиту в четыре часа. Поведение повторялось и на Qwen3.8-27B (xhigh), и на GLM-5.3-Flash (max), каждый раз на других задачах, поэтому в статье приведены средние оценки по прогонам без сбоя.
Кеширование префикса у Codex и Pi держалось в среднем от 94,17% до 96,58% на обеих моделях, у исправленной версии Claude Code на Qwen3.8-27B оно составило 97,36%. В версии 2.1.233 средняя доля попаданий упала до 29,84% при p10–p90 в 23,4–37,8%, одновременно ухудшились время до первого токена и скорость генерации.
Когда выйдет разбор поведения агентов
Авторы сообщают, что при детальном разборе действий агентов нашли поведение, из-за которого эксперимент пришлось перезапускать несколько раз; описание обещано в следующем материале на следующей неделе. Отдельная статья о влиянии инференс-движка на стек заявлена через одну-две недели, точные даты публикаций не названы. Команда также предупреждает, что связки моделей и обвязок меняются быстро и её замеры будут обновляться.
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.
Из Google мы используем только имя и аватар. Почту не сохраняем.