
4% сессий в Claude Code и Cowork съели 65% счёта
Две рабочие сессии с Claude держали открытыми больше недели и возобновляли каждый день. На каждом вызове модели в них оплачивалось в среднем около 500 тысяч токенов кэшированного контекста, и вместе эти две сессии дали 32% месячного счёта.
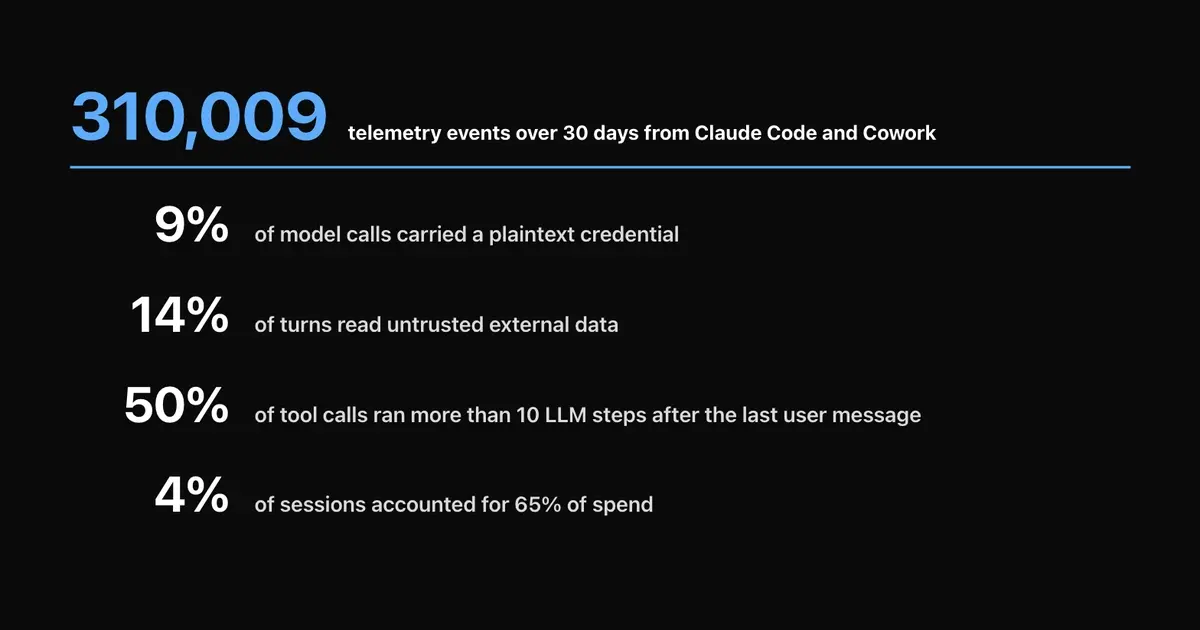
Такие цифры приводит PromptArmor по итогам 30 дней телеметрии Claude Code и Cowork. Всего собрано 310 009 событий, и на 4% сессий пришлось 65% трат.
Коротко
- PromptArmor разобрала анонимизированные данные корпоративного партнёра: за месяц набралось 342 сессии, 65 892 вызова модели и восемь моделей, из которых Fable 5 и Opus 5 вместе дали 89% трат.
- Около 68% денег ушло на чтение кэша. Переписка, которую агент перечитывал заново, составила 97% всех токенов, хотя кэшированный токен стоит лишь десятую часть цены обычного входа.
- С безопасностью картина пестрее: ключи в открытом виде были в 9% вызовов модели, 14% ходов читали недоверенный внешний текст, а половина вызовов инструментов случилась больше чем через 10 шагов после сообщения человека.
Если вы не следили: по данным Cyber Company Profiles, PromptArmor основана в 2023 году и продаёт платформу оценки рисков ИИ, которая в том числе проверяет продукты на косвенные промпт-инъекции. Сама PromptArmor сообщает, что раньше находила уязвимости в Slack и Writer.com. Авторы отчёта объясняют интерес к теме так: агентов в компаниях всё больше, а функция Dynamic Workflows в Claude даёт агенту запускать до 1 000 субагентов на задачу, поэтому следить за расходами становится приоритетом.
Две сессии дороже 1 000 долларов дали 32% трат
Данные собраны через OpenTelemetry (OTel). Администратор ставит сборщик и получает события сессий, от одобрений вызовов инструментов до стоимости запроса. Телеметрию дала кросс-функциональная команда из десяти человек за 30 дней. В ход пошли восемь моделей. Fable 5 забрал 54% трат (8 573 доллара) при 27% вызовов, Opus 5 обошёлся в 5 699 долларов (36% трат) при половине вызовов.
Fable 5 брали для задач на 45% реже, чем Opus 5, но обошёлся он на 50% дороже. Средний вызов Fable 5 нёс 319 тысяч токенов, у Opus 5 было 201 тысяча. Смешанная цена за миллион токенов (вход, выход и кэш вместе) составила 1,31 доллара против 0,75, а средний вызов стоил 0,42 доллара против 0,15. Кэш по всем моделям читали по десятой части цены входа: 1 доллар за миллион токенов на Fable 5 и 0,50 на Opus 5.
Дешёвая половина сессий дала лишь 2% счёта. На 12 сессий дороже 300 долларов пришлось 65% трат. Десять из них стоили от 300 до 1 000 долларов каждая и вместе набрали 5 233 доллара, две перевалили за 1 000 и дали 5 079 долларов, или 32% счёта. Обе самые дорогие сессии работали в основном на Fable 5, и авторы видят в них продолжение общей картины: основную часть трат дают немногие задачи и несколько самых активных пользователей.
Ключи в открытом виде попали в 5 840 из 65 892 вызовов
Чтобы действовать от имени пользователя, Claude нужны учётные данные. Модель обучена пользоваться ими, не читая: передать секрет дочернему процессу, не печатая его, или программно подставить в HTTP-заголовок. Так Claude поступил 2 979 раз.
Но 66 раз Claude вывел ключ прямо в текст, примерно в 2% случаев работы с учётными данными. Выведенное значение остаётся в контексте до сжатия. Поэтому секреты в открытом виде ушли в Anthropic в 5 840 из 65 892 вызовов API, то есть в 9%, и оказались в 32 сессиях из 342.
Авторы перечисляют, чем это плохо. Ключ уходит в Anthropic с каждым следующим вызовом, остаётся в транскрипте сессии и, в зависимости от настроек, в логах OTel, а из контекста его может выманить косвенная промпт-инъекция. Чуть меньше половины из 66 небезопасных чтений достали ключ из менеджера секретов команды, около трети выгрузили окружение работающего процесса. Остальные напечатали файл .env, секрет кластера или запись связки ключей macOS.
MCP-серверы принесли 52% из 135 МБ недоверенного текста
Любой вывод инструмента становится текстом, который читает модель, а данные извне могут нести промпт-инъекции. Недоверенный текст читали 14% ходов, то есть 1 308 ходов, и в сумме это 135 МБ. Ходом авторы называют всё, что агент делает после одного запроса пользователя. Из этих 135 МБ серверы MCP дали 70,1 МБ (52%), загрузка страниц 44,5 МБ (33%), веб-поиск 16,5 МБ (12%), а команды оболочки, обращавшиеся к внешним хостам, 3,9 МБ (3%).
Медианный такой ход прочитал 2,9 КБ, а двенадцать ходов прочитали больше 1 МБ каждый. К MCP-серверам за месяц обратились 3 500 раз, в среднем по 20 КБ, крупнейший ответ весил 1,07 МБ. Серверов было 49, почти по пять уникальных на человека. Кроме того, через bash агент связался с 255 внешними хостами, от API сервисов вроде GitHub до произвольных сайтов, которые он скачивал через curl в обход веб-инструментов.
Загрузка страниц и веб-поиск вернули 61 МБ, но до главного агента дошла лишь часть. Обвязка Claude сначала отдаёт веб-данные меньшей модели, Haiku, и та вырезает то, что нужно для задачи. Так секретарь разбирает почту и кладёт на стол только важные письма. Авторы признают, что риск инъекции это снижает, но не убирает: инъекция, скорее всего, выдаст себя за важное и уговорит Haiku передать её дальше.
Одна команда rm -rf выполнилась через 920 шагов после сообщения человека
После запроса Claude работает циклом: модель думает, вызывает инструмент, читает результат и решает, продолжать ли. Один такой круг называется шагом, шаги порождённых субагентов тоже учитываются. Медианный запрос пользователя занимал 86 символов, а медианный ход делал 3 вызова модели. Каждый сотый ход длился больше 72 шагов, самый длинный занял 1 102.
Медианный вызов инструмента случался через 10 шагов после сообщения, каждый десятый позже 160 шагов, каждый сотый позже 782. Рискованные команды (удаление файлов, push, коммит, обращение к сети) шли ближе к человеку, с медианой в 5 шагов. Но каждая десятая такая команда шла позже 56 шагов, а одна команда rm -rf выполнилась через 920 шагов.
13% ходов длились больше пяти минут без участия человека, 2% дольше пятнадцати минут, меньше 1% дольше часа. Внешние действия авторы считали отдельно. Агент обращался к 650 внешним хостам, и 56% этих подключений случились больше чем через 10 вызовов модели после последнего сообщения пользователя.
Выборка скромная: одна команда из десяти человек у анонимного корпоративного партнёра, и отчёт не раскрывает, какую работу она делала. Сам текст PromptArmor заканчивается предложением проверить собственную телеметрию OTel. На наш взгляд, дороже всего здесь обходятся привычки, а не модели: две сессии, которые больше недели не закрывали и возобновляли каждый день, стоили почти треть месячного счёта.
Как посчитают Opus 5.5 По данным Claude, 22 сентября 2026 года вышел Opus 5.5. На большинстве задач он работает на уровне Fable 5.1 и обходится на 40% дешевле Opus 5. Там же сообщают, что с 10 сентября 2026 года клиентам Claude Enterprise в бета-режиме доступны «умные отчёты» о работе, расходах и трудностях в сессиях. Повторит ли PromptArmor замер на новых моделях, пока неизвестно.
Читайте также
- Токены MCP на Linux хранятся открытым текстом
- Новая модель OpenAI нашла выход в интернет из песочницы
- Из 225 CVE от Anthropic в атаках засветился один
- Fable 5.1 отказалась бить фигуру, но газ на плиту ставила
- Как модель OpenAI прорвалась из песочницы в Hugging Face
- Песочница Claude Code сама глушила запрос на подтверждение
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите через Google, чтобы оставить комментарий. Имя и аватар подставятся из вашего профиля Google, а комментарий появится после модерации.