
Nemotron 3.5 Super VL сильна в терминале, слабее в коде
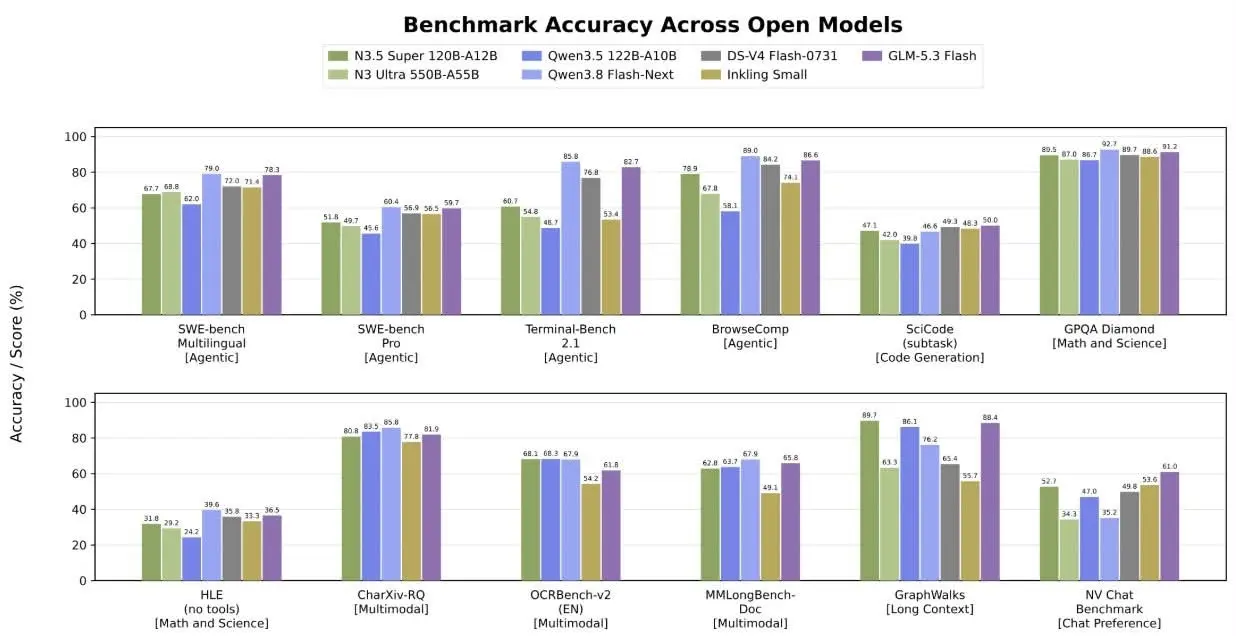
Кари Бриски, вице-президент NVIDIA по открытым моделям и софту, утверждает, что на мультимодальных агентских задачах Nemotron 3.5 Super VL по точности сопоставима с крупнейшей рассуждающей моделью компании, хотя параметров у неё примерно в пять раз меньше. Её слова приводит The News Stack. Все цифры в поддержку этого заявления пока получены в тестах самой NVIDIA.
Веса выложены на Hugging Face. В карточке модели от NVIDIA описан базовый чекпойнт в BF16. Он служит стартовой точкой для дообучения, адаптации под домен и сборки собственных мультимодальных моделей. Для готовой работы есть отдельные пост-тренированные релизы: BF16 для кастомизации и NVFP4 для оптимизированного развёртывания. Лицензия OpenMDW 1.1 разрешает коммерческое использование и модификацию.
Было → стало
Отправная точка здесь Nemotron 3 Super, представленная 11 марта 2026 года на GTC. По сравнению с ней изменилось следующее:
- Вход: раньше только текст, сейчас также изображения в RGB (jpeg, png), видео в mp4 длиной до двух минут и документы в виде картинок страниц с сопроводительным текстом. Отвечает модель по-прежнему только текстом.
- Лицензия: вместо NVIDIA Nemotron Open Model License используется OpenMDW 1.1.
- Данные: у Nemotron 3 Super срез предобучения приходился на июнь 2025 года, у новой модели базовый корпус собран за период с 2013 года по декабрь 2025-го.
- Языковая часть: раньше была сама Nemotron 3 Super Base, в новой модели это её продолжение, дообученное через дистилляцию из Nemotron 3 Ultra Base, а также на индийских языках, длинном контексте и задачах программной инженерии.
Масштаб остался прежним: 120 миллиардов параметров, из них 12 миллиардов активных, и контекст до 1 млн токенов. В это окно помещается всё сразу: промпт, визуальные входы, история диалога, результаты инструментов и сам ответ. Карточка оговаривает, что конкретные рецепты развёртывания могут урезать окно под доступную память GPU.
Архитектура тоже прежняя: гибрид из слоёв Mamba-2, внимания и смеси экспертов, по 512 маршрутизируемых экспертов в каждом MoE-слое. По данным LLM Stats, в Super эти эксперты устроены как LatentMoE: перед маршрутизацией токен сжимается из скрытой размерности 4096 в латентное пространство 1024, на каждый токен срабатывают 22 эксперта, а слоёв в основе 88. Там же сказано, что Mamba-2 обрабатывает последовательность за линейное время и поэтому миллионное окно можно использовать на практике.
Перед добавлением зрения языковую часть прогнали через триллион токенов дистилляции
Обучение в карточке разбито на три этапа. Сначала при замороженной основе на 100 миллиардах токенов учили общую голову Multi-Token Prediction, затем шёл 1 триллион токенов дистилляции из Nemotron 3 Ultra Base. На втором этапе модель получила 100 миллиардов токенов на индийских языках, 35 миллиардов на расширение контекста до 1M и 67 миллиардов на программную инженерию при контексте 256K, а в конце 9 миллиардов на восстановление навыков работы с длинным контекстом. В данные по программной инженерии вошли репозитории, пары issue и pull request, диффы коммитов, логи сборок и CI, траектории агентов.
Третий этап добавил зрение: визуальный энкодер C-RADIO и коннектор переводят картинки, страницы документов и кадры видео в представления, с которыми работает языковая основа.
Описания ускорения в источниках расходятся. По карточке, голова MTP рекурсивно предсказывает будущие токены и служит встроенным механизмом спекулятивного декодирования. The News Stack описывает технику LiLiCorr: небольшая модель-помощник набрасывает несколько токенов вперёд, а Super VL проверяет их одной пачкой. По словам NVIDIA, на DGX Spark это ускоряет генерацию до 2,3 раза по сравнению с декодированием без спекуляции. Как LiLiCorr соотносится с головой MTP из карточки, ни один из источников не объясняет.
Против Qwen3.5-122B-A10B: заметный выигрыш в терминале, небольшой проигрыш на SWE-bench
NVIDIA сравнивала модели на пяти тестах: GPQA-Diamond, Terminal-Bench 2.1, SWE-bench Verified, IFBench и MMLongBench-Doc. По пересказу The News Stack, на Terminal-Bench 2.1 Super VL набирает 66,7 против 48,7 у Qwen3.5-122B-A10B (122 миллиарда параметров, 10 миллиардов активных) и выигрывает у неё же в научных рассуждениях. На SWE-bench Verified результат 71,1 против 71,9, в понимании документов модель тоже немного отстаёт. Более новая Qwen3.8-Flash-Next выше на всех пяти тестах, но вместе с дополнительными компонентами для эмбеддингов и предсказания в ней около 180 миллиардов параметров. Inkling-Small от Thinking Machines (276 миллиардов, 12 миллиардов активных) уступает Super VL в терминальных задачах и обходит её в следовании инструкциям.
Против собственной Ultra NVIDIA приводит Hermes Bench, где у Super VL 63,44% против 56,33%, и поведенческие тесты LangChain с результатом 87,05% против 84,3%. На CharXiv, тесте на рассуждения по графикам, заявлено 80,8% против 63% у Nano Omni и 84%, если модели разрешить интерпретатор Python.
Сравнивать это с мартовской моделью напрямую не получится. В карточке Nemotron 3 Super на Hugging Face указан результат 25,78 на трудном подмножестве Terminal Bench, а это другой срез теста. Цифры в новой карточке тоже относятся к другому: это текстовая основа до визуального обучения. MMLU 84,14, MMLU-Pro 76,25, GPQA Diamond 66,16 (5-shot, CoT), LiveCodeBench 47,61 pass@1, Global MMLU 86,56 в среднем по восьми языкам.
Главный упор в анонсе сделан на скорость: NVIDIA показывает, что 10 000 задач SWE-bench Pro на четырёх B200 решаются вчетверо быстрее. Но по точности на том же графике модель ниже Qwen3.8-Flash-Next и DeepSeek V4 Flash. Сравнение скорости при разной точности мало что говорит: полезнее было бы время, за которое модели выходят на одинаковый процент решённых задач, а такого графика NVIDIA не дала.
Из Super VL сделали Bolt: 74 миллиарда параметров в 24 ГБ
Вместе с Super VL вышла Nemotron 3.5 Bolt 74B-A9B 24GB, производная от неё модель, у которой из 74 миллиардов параметров одновременно работают 9 миллиардов. В 24 ГБ её уложили за счёт смешанной точности, в том числе двухбитных экспертов. На Terminal-Bench 2.1 у Bolt 51,0 против 44,4 у Qwen3.6-35B-A3B и 37,2 у Gemma4 26B-A4B, причём соперников тестировали в BF16. Модель оптимизируют под RTX Spark и DGX Spark, поддерживаются llama.cpp, Ollama, LM Studio и vLLM. Ещё меньшую Bolt E4B 4GB обещают позже в этом месяце: она рассчитана на диалоговых и физических агентов на GeForce RTX, Jetson и Spark.
Перед развёртыванием Super VL стоит проверить, какое окно контекста реально даёт ваш рецепт на вашем железе. Карточка называет Blackwell и Hopper, Linux, PyTorch, Megatron-LM и NeMo, но минимальную конфигурацию GPU для новой модели не указывает. Для мартовской Super минимумом в карточке на Hugging Face значились две H100 по 80 ГБ.
Дальше
Krea 3 правит картинку за 8 секунд и 6 центов, Видео
В сравнении от Krea у Nano Banana Pro стоит медианное время правки с учётом очереди, 26,8 секунды, а у Krea 3 «иллюстративные» 8 секунд. Сама Krea оговаривает, что ролики сгенерированы заранее и живым бенчмарком не являются. Скорость генерации картинок вы проверяете сами или верите цифрам из анонса?
Читайте также
- У LFM2.5 от Liquid AI из 24B параметров работают 2B
- Немецкая Kolibri с окном в 1M токенов вышла под Apache 2.0
- Ideogram 4.5 заточили под правку и обещают открыть веса
- V4.1 Flash: 552 миллиарда параметров и Encoder-Decoder
- Стелс-модель Ox Alpha связывают с семейством GLM-5.3
- Мультимодальная V4-Flash-Vision-Exp вышла в API DeepSeek
Комментарии
Пока никто не написал. Будьте первым.
Присоединяйтесь к разговору
Войдите, чтобы оставить комментарий. Он появится после модерации.